Lezione 10: Algoritmi Iterativi di Ordinamento e Ricerca
Nelle lezioni precedenti abbiamo visto come allocare, scansionare e manipolare dati in memoria RAM organizzandoli in strutture sequenziali (gli array monodimensionali e le matrici multidimensionali). Tuttavia, la vera utilità dei dati risiede nella nostra capacità di elaborarli in modo efficiente. In questa lezione affronteremo uno dei pilastri fondamentali dell’informatica: l’ordinamento dei dati. Impareremo tre algoritmi iterativi classici (Selection Sort, Bubble Sort e Insertion Sort) analizzando come lavorano sui puntatori e indici a livello fisico, e scopriremo come l’ordinamento sia la chiave per abilitare la Ricerca Dicotomica (Binary Search), una delle ottimizzazioni algoritmiche più potenti ed eleganti della programmazione.
1. Il Ruolo dell’Ordinamento e lo Swap
Sezione intitolata “1. Il Ruolo dell’Ordinamento e lo Swap”1.1 Perché Ordiniamo i Dati?
Sezione intitolata “1.1 Perché Ordiniamo i Dati?”Per comprendere l’importanza dell’ordinamento, immaginiamo uno scenario reale: cercare un nominativo specifico all’interno di un elenco telefonico di un milione di persone.
- Se l’elenco fosse disordinato, non avremmo altra scelta se non quella di esaminare i nomi uno ad uno, dal primo all’ultimo. Nel caso peggiore (nominativo assente o all’ultima pagina), dovremmo effettuare esattamente 1 milione di confronti.
- Se l’elenco è ordinato alfabeticamente, possiamo individuare il nome in pochissimi secondi aprendo l’elenco a metà, scartando la porzione non utile e ripetendo il processo. Come vedremo, per un milione di persone basteranno al massimo 20 confronti.
L’ordinamento è quindi la precondizione fondamentale che trasforma la ricerca di un’informazione da un processo estenuante a una frazione infinitesima di secondo.
1.2 La Funzione swap con Puntatori
Sezione intitolata “1.2 La Funzione swap con Puntatori”Tutti gli algoritmi di ordinamento che analizzeremo si basano su un’operazione fondamentale: lo scambio (swap) di posizione tra due elementi in memoria. Per evitare che la copia sovrascriva un valore cancellandolo, dobbiamo utilizzare una variabile temporanea di appoggio. Sfruttando i puntatori (come introdotto nella Lezione 8), la funzione si presenta così:
void swap(int *a, int *b) { int temp = *a; // Salva il valore puntato da a in una cassaforte temporanea *a = *b; // Copia il valore puntato da b nell'indirizzo di a *b = temp; // Sposta il valore temporaneo nell'indirizzo di b}2. Il Mescolamento Casuale: Fisher-Yates Shuffle
Sezione intitolata “2. Il Mescolamento Casuale: Fisher-Yates Shuffle”Prima di affrontare il problema di mettere in ordine un array, consideriamo il problema opposto: mescolarlo in modo completamente casuale ed equo. Questa operazione, nota come shuffling, è fondamentale in ambiti quali simulazioni, videogiochi (es. mescolare un mazzo di carte) o generazione di chiavi di cifratura.
2.1 Perché lo Shuffling “Ingenuo” è Sbagliato
Sezione intitolata “2.1 Perché lo Shuffling “Ingenuo” è Sbagliato”Un approccio istintivo potrebbe essere quello di scorrere l’array e scambiare ogni elemento con un altro scelto a caso tra tutti gli indici dell’array:
// Algoritmo errato / distorto!for (int i = 0; i < n; i++) { int j = rand() % n; // Scelta tra 0 e n-1 swap(&arr[i], &arr[j]);}Sebbene sembri corretto, questo metodo genera permutazioni non uniformi. In un array di elementi, ci sono permutazioni possibili. L’algoritmo sopra effettua scelte, ciascuna con possibilità, per un totale di possibili percorsi. Poiché non è quasi mai divisibile per , alcune permutazioni saranno statisticamente più frequenti di altre, introducendo una forte distorsione (bias).
2.2 L’Algoritmo di Fisher-Yates
Sezione intitolata “2.2 L’Algoritmo di Fisher-Yates”L’algoritmo di Fisher-Yates (nella versione moderna di Durstenfeld) risolve questo problema riducendo progressivamente lo spazio di scelta.
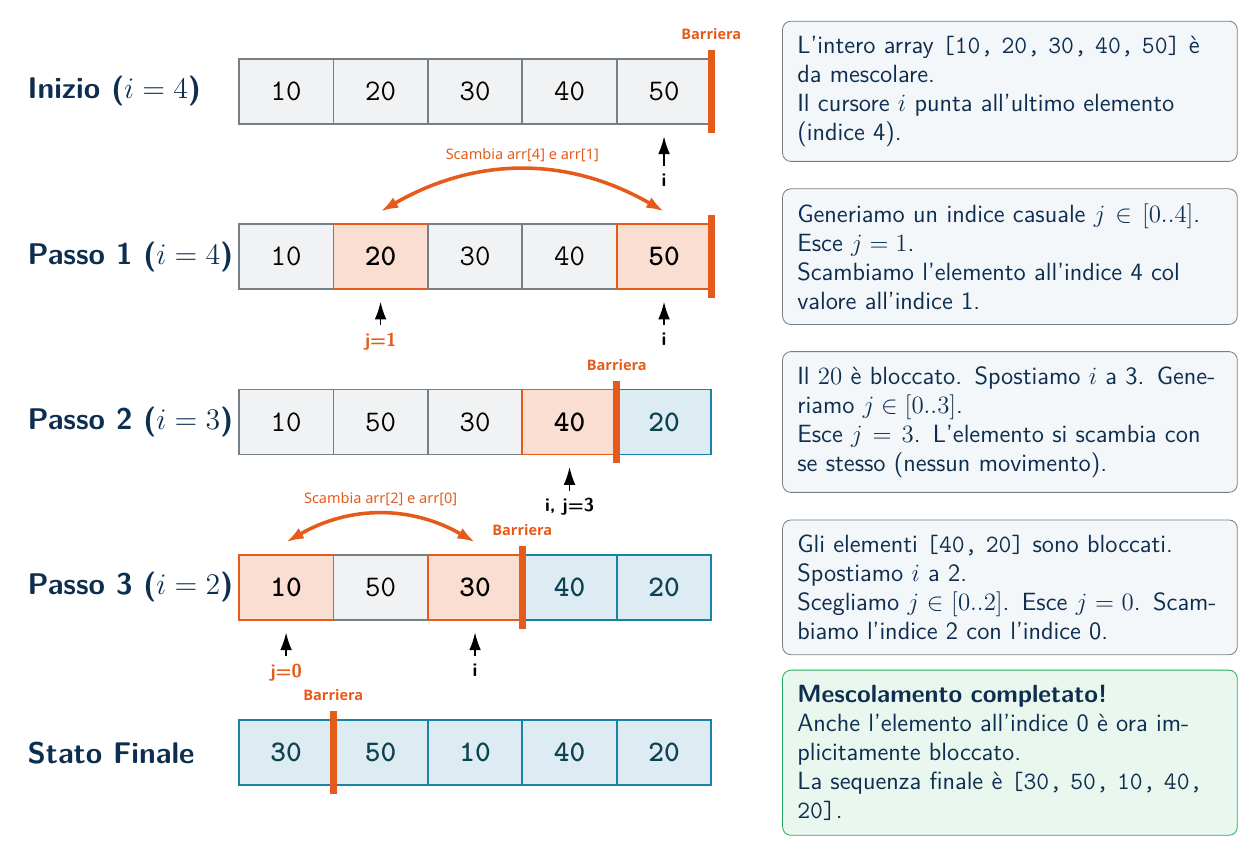
- Si posiziona una barriera virtuale che inizialmente esclude l’intero array.
- Si parte dall’ultimo elemento dell’array (indice ).
- Si sceglie un indice casuale compreso tra e (incluso).
- Si scambiano gli elementi in posizione e .
- Si decrementa di uno e si ripete il processo fino all’indice .
A ogni passo l’elemento scambiato finisce a destra della barriera rossa ed è bloccato; lo spazio di scelta si restringe esattamente a elementi. Poiché il numero di percorsi possibili è esattamente , ogni permutazione ha esattamente probabilità di verificarsi. L’algoritmo opera in tempo lineare e in-place (senza memoria aggiuntiva).
Codice C del Fisher-Yates Shuffle:
Sezione intitolata “Codice C del Fisher-Yates Shuffle:”void fisher_yates(int arr[], int n) { for (int i = n - 1; i > 0; i--) { // Sceglie un indice casuale tra 0 e i (incluso) int j = rand() % (i + 1);
// Scambia solo se gli indici differiscono if (i != j) { swap(&arr[i], &arr[j]); } }}3. I Tre Algoritmi di Ordinamento Iterativi
Sezione intitolata “3. I Tre Algoritmi di Ordinamento Iterativi”3.1 Selection Sort: “Trova il Minimo”
Sezione intitolata “3.1 Selection Sort: “Trova il Minimo””La strategia del Selection Sort è estremamente intuitiva:
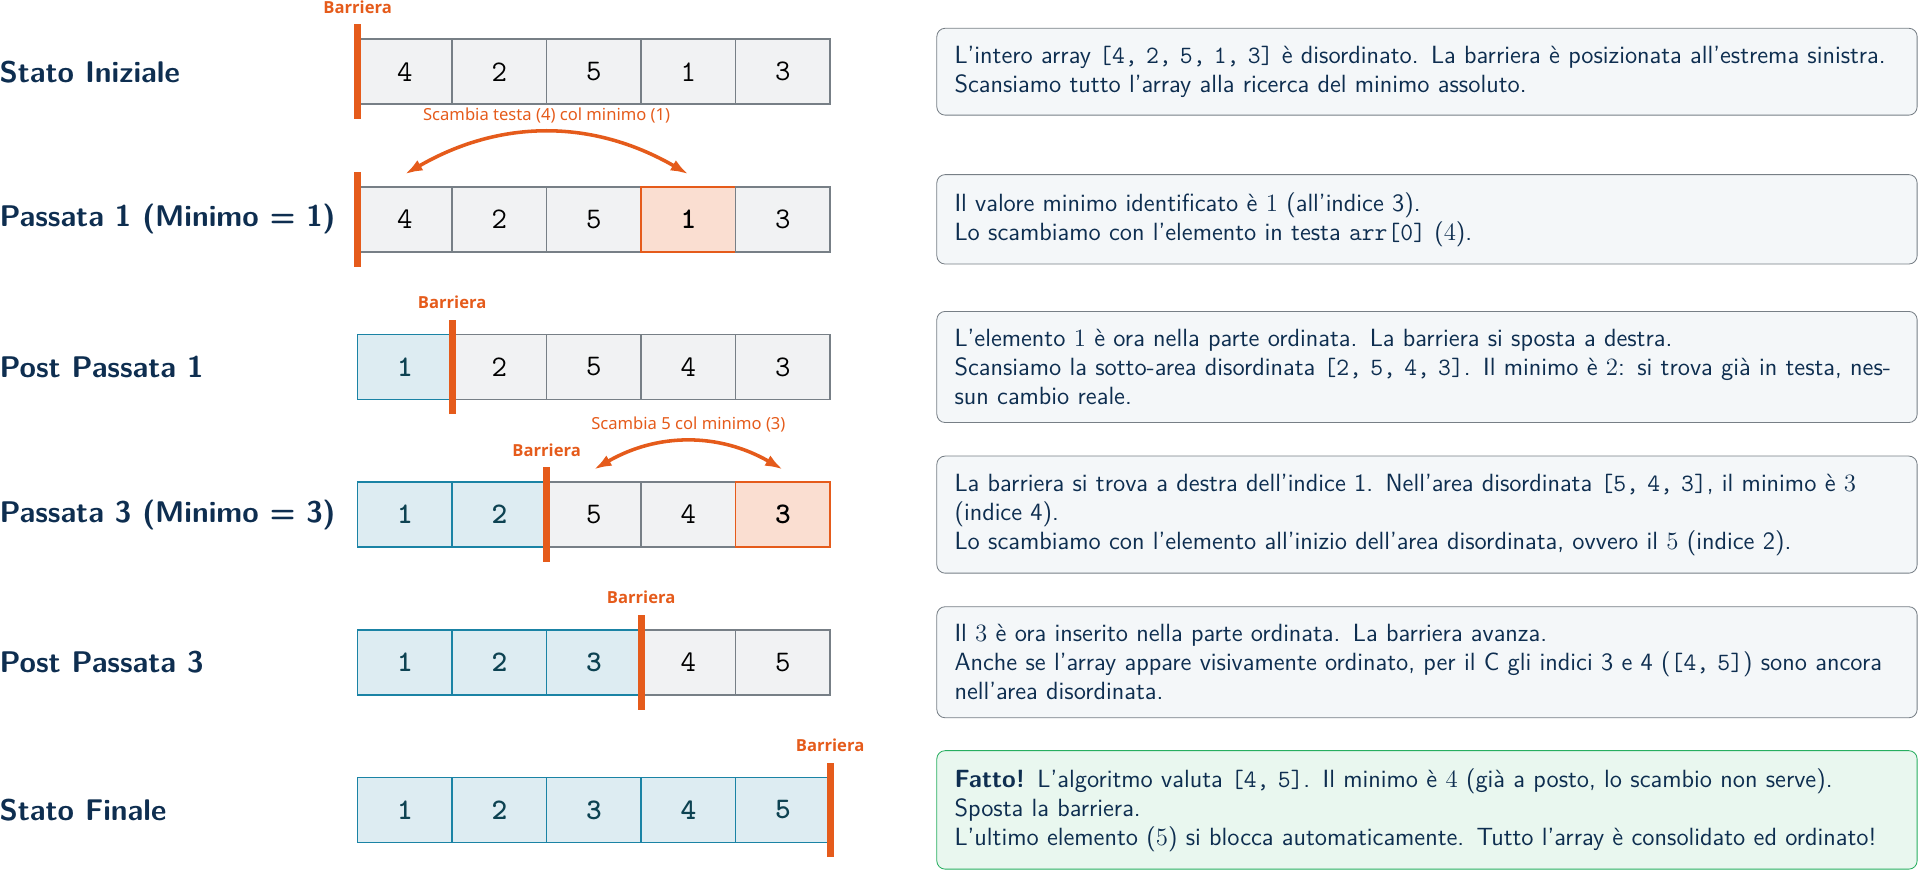
- Immaginiamo una barriera logica che separa l’array in due parti: a sinistra gli elementi già ordinati, a destra quelli ancora disordinati. All’inizio l’intero array è disordinato.
- Scansioniamo l’area disordinata alla ricerca del valore minimo.
- Scambiamo questo valore minimo con l’elemento che si trova all’estrema sinistra dell’area disordinata.
- Spostiamo la barriera di un passo verso destra e ripetiamo il processo per la parte rimanente dell’array.
Codice C Completo del Selection Sort:
Sezione intitolata “Codice C Completo del Selection Sort:”#include <stdio.h>
void swap(int *a, int *b) { int temp = *a; *a = *b; *b = temp;}
void selection_sort(int arr[], int n) { // La barriera 'i' avanza fino al penultimo elemento dell'array for (int i = 0; i < n - 1; i++) { int min_idx = i; // Assumiamo temporaneamente che il minimo sia all'indice 'i'
// Scansione della sotto-area disordinata (a destra di 'i') for (int j = i + 1; j < n; j++) { if (arr[j] < arr[min_idx]) { min_idx = j; // Trovato un nuovo minimo, memorizziamo l'indice } }
// Se il minimo identificato non coincide con la testa corrente, scambiamo if (min_idx != i) { swap(&arr[i], &arr[min_idx]); } }}
int main(void) { int dati[] = {4, 2, 5, 1, 3}; int n = 5;
selection_sort(dati, n);
printf("Selection Sort: "); for(int i = 0; i < n; i++) { printf("%d ", dati[i]); } printf("\n"); return 0;}3.2 Bubble Sort: “Le Bollicine in RAM”
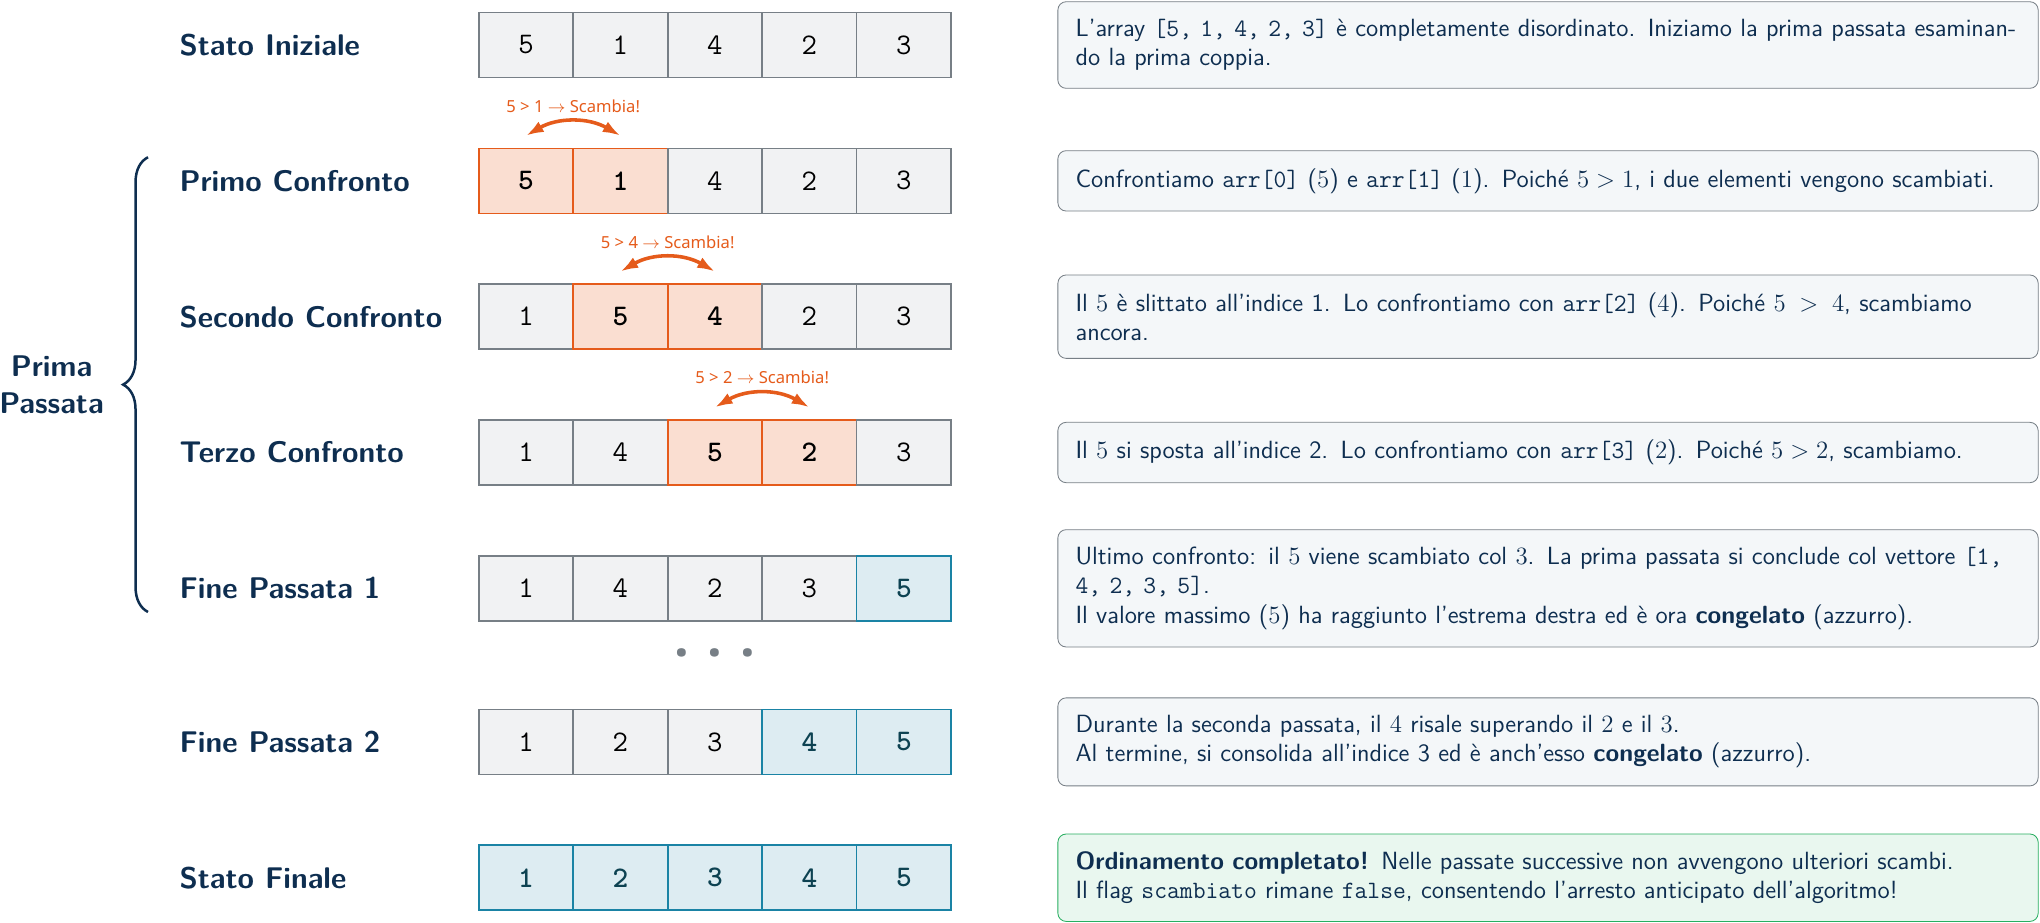
Sezione intitolata “3.2 Bubble Sort: “Le Bollicine in RAM””L’idea fondamentale del Bubble Sort è far risalire gli elementi più grandi verso l’estremità destra dell’array (come bollicine di anidride carbonica in un bicchiere d’acqua):
- Si confronta ciascun elemento con il suo adiacente destro (
arr[j]conarr[j+1]). - Se l’elemento di sinistra è maggiore di quello di destra, vengono scambiati.
- Al termine della prima passata completa, l’elemento massimo assoluto avrà necessariamente raggiunto l’ultima cella dell’array.
- Si ripete la passata per i rimanenti elementi, congelando progressivamente gli elementi massimi a destra.
L’Ottimizzazione del Flag scambiato
Sezione intitolata “L’Ottimizzazione del Flag scambiato”Nella sua versione base, il Bubble Sort esegue sempre tutti i cicli anche se l’array viene ordinato a metà dell’opera. Possiamo ottimizzarlo introducendo una variabile booleana scambiato: se durante una passata completa non avviene alcun scambio fisico, significa che l’array è già perfettamente ordinato ed è inutile continuare.
Codice C Completo del Bubble Sort Ottimizzato:
Sezione intitolata “Codice C Completo del Bubble Sort Ottimizzato:”#include <stdio.h>#include <stdbool.h>
void swap(int *a, int *b) { int temp = *a; *a = *b; *b = temp;}
void bubble_sort(int arr[], int n) { bool scambiato; for (int i = 0; i < n - 1; i++) { scambiato = false;
// Gli ultimi 'i' elementi sono già consolidati (congelati) for (int j = 0; j < n - i - 1; j++) { if (arr[j] > arr[j + 1]) { swap(&arr[j], &arr[j + 1]); scambiato = true; // Uno scambio è avvenuto } }
// Se non ci sono stati scambi, l'array è ordinato. Uscita anticipata! if (!scambiato) { break; } }}
int main(void) { int dati[] = {5, 1, 4, 2, 3}; int n = 5;
bubble_sort(dati, n);
printf("Bubble Sort: "); for(int i = 0; i < n; i++) { printf("%d ", dati[i]); } printf("\n"); return 0;}3.3 Insertion Sort: “L’Ordinamento delle Carte”
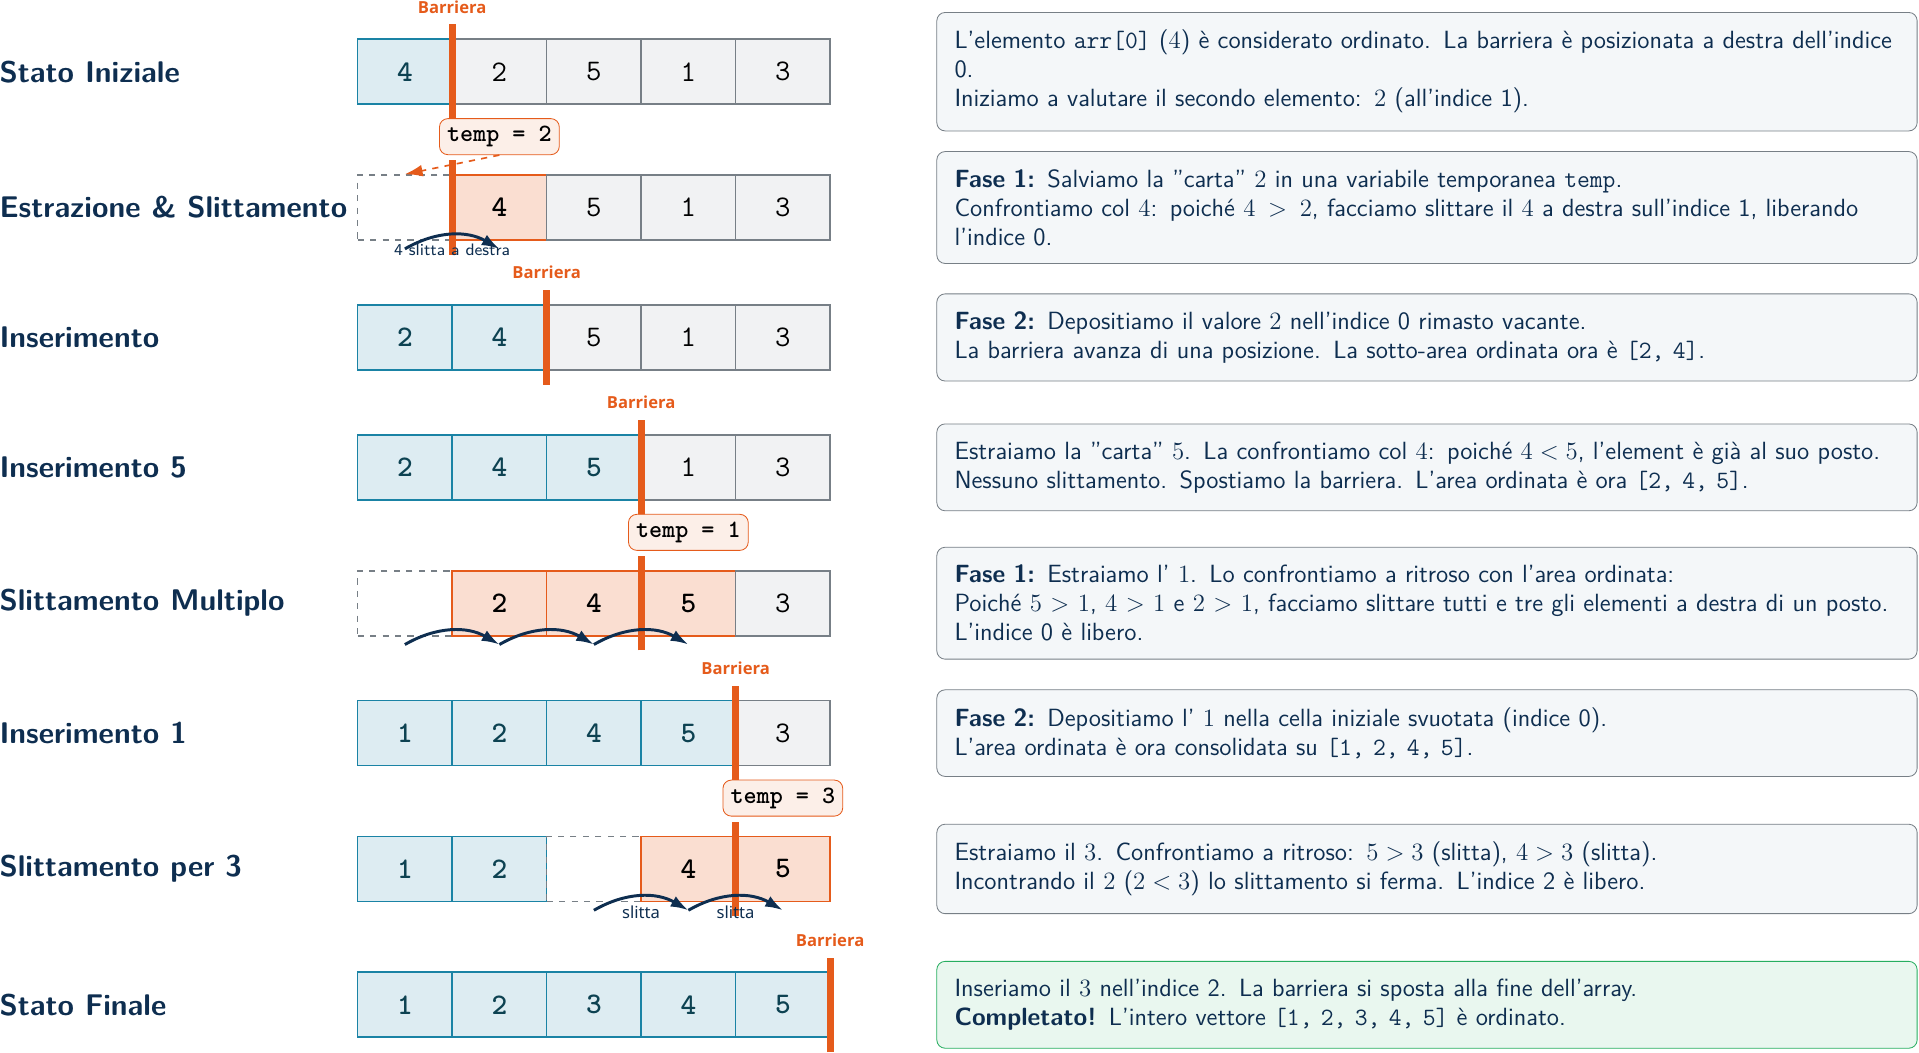
Sezione intitolata “3.3 Insertion Sort: “L’Ordinamento delle Carte””L’Insertion Sort ricalca fedelmente il modo in cui ordiniamo le carte da gioco che teniamo in mano:
- Consideriamo il primo elemento (
arr[0]) come un sotto-array già ordinato di lunghezza 1. - Esaminiamo il secondo elemento. Lo “estraiamo” memorizzandolo in una variabile temporanea
temp(la nostra carta in mano). - Fase di Slittamento (Shifting): Confrontiamo
tempa ritroso con gli elementi della porzione ordinata a sinistra. Finché questi elementi sono maggiori ditemp, li facciamo slittare a destra di una posizione (sovrascrivendo la cella successiva). - Fase di Inserimento: Non appena troviamo un elemento minore o uguale a
temp(o raggiungiamo l’inizio dell’array), inseriamo la nostra “carta” nella posizione vuota rimasta libera.
Codice C Completo dell’Insertion Sort:
Sezione intitolata “Codice C Completo dell’Insertion Sort:”#include <stdio.h>
void insertion_sort(int arr[], int n) { // arr[0] è assunto già ordinato. Partiamo dall'indice 1 for (int i = 1; i < n; i++) { int temp = arr[i]; // Estraiamo l'elemento corrente int j = i - 1;
// Spostiamo verso destra tutti gli elementi maggiori di temp while (j >= 0 && arr[j] > temp) { arr[j + 1] = arr[j]; // Slittamento fisico a destra j--; // Continuiamo la scansione a ritroso }
// Inseriamo temp nella posizione corretta liberata dallo slittamento arr[j + 1] = temp; }}
int main(void) { int dati[] = {4, 2, 5, 1, 3}; int n = 5;
insertion_sort(dati, n);
printf("Insertion Sort: "); for(int i = 0; i < n; i++) { printf("%d ", dati[i]); } printf("\n"); return 0;}4. La Ricerca Dicotomica (Binary Search)
Sezione intitolata “4. La Ricerca Dicotomica (Binary Search)”4.1 Ricerca Lineare vs Dicotomica
Sezione intitolata “4.1 Ricerca Lineare vs Dicotomica”La ricerca di un elemento in un array può essere condotta in due modi:
- Ricerca Lineare: Scorre l’array dall’inizio e confronta ogni cella con la chiave cercata. Funziona su array sia ordinati che disordinati, ma richiede in media confronti e confronti nel caso peggiore.
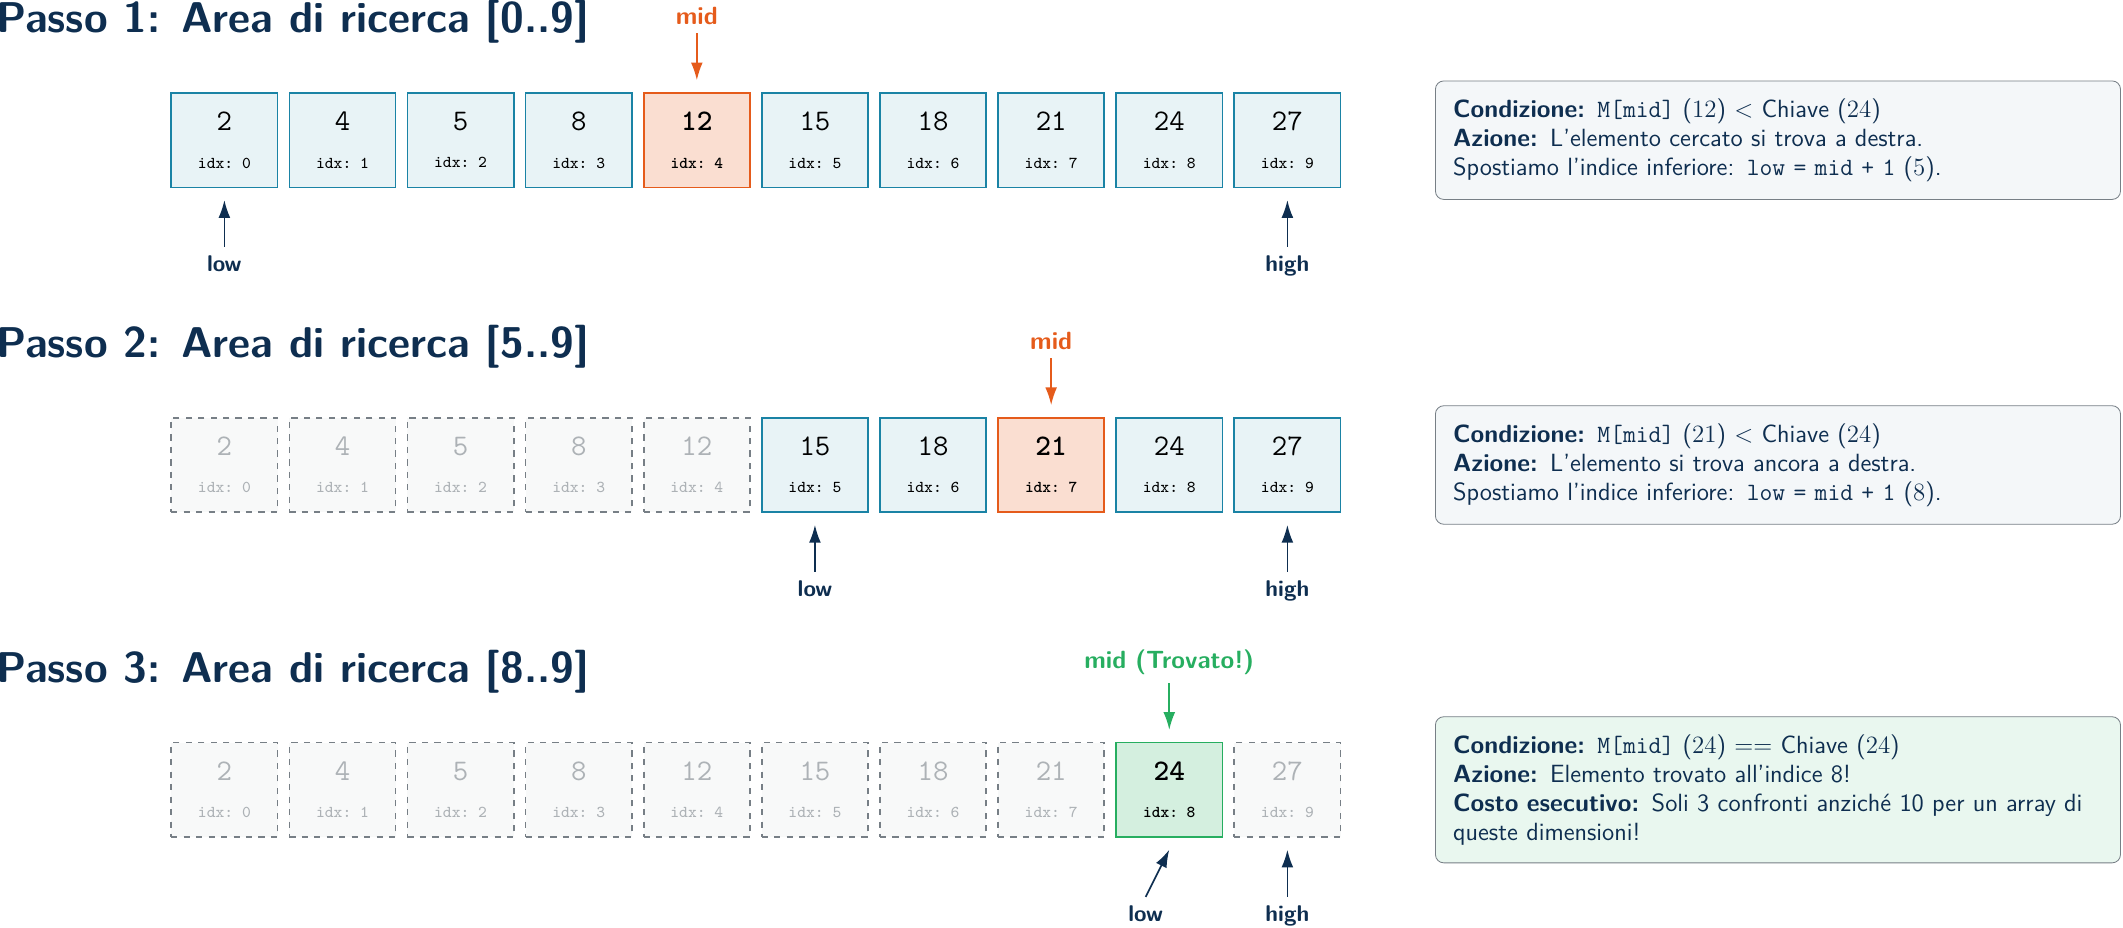
- Ricerca Dicotomica (Binary Search): Richiede che l’array sia rigorosamente ordinato. Adotta una strategia di tipo Divide et Impera: confronta la chiave con l’elemento centrale. Se sono diversi, scarta la metà dell’array in cui la chiave non può risiedere e ripete la ricerca nella metà rimanente.
4.2 Prevenire l’Overflow nel Calcolo del Punto Medio
Sezione intitolata “4.2 Prevenire l’Overflow nel Calcolo del Punto Medio”Nel calcolare l’indice centrale, la formula intuitiva sarebbe (low + high) / 2. Tuttavia, se low e high assumono valori molto grandi (vicini al limite superiore del tipo int, pari a ), la loro somma diretta provocherà un integer overflow, producendo un valore negativo e causando un crash di segmentazione durante l’accesso all’array.
Per evitare questo bug critico, si adotta la formula aritmeticamente equivalente ma sicura:
In questo modo, la sottrazione high - low non potrà mai superare la dimensione dell’area, scongiurando il rischio di overflow.
Codice C della Ricerca Dicotomica:
Sezione intitolata “Codice C della Ricerca Dicotomica:”#include <stdio.h>
// Restituisce l'indice dell'elemento se trovato, altrimenti -1int ricerca_dicotomica(int arr[], int n, int chiave) { int low = 0; int high = n - 1;
while (low <= high) { // Calcolo sicuro del punto medio per evitare overflow numerico int mid = low + (high - low) / 2;
if (arr[mid] == chiave) { return mid; // Trovato! Restituiamo l'indice }
if (arr[mid] < chiave) { low = mid + 1; // La chiave si trova nella metà destra } else { high = mid - 1; // La chiave si trova nella metà sinistra } }
return -1; // Chiave non presente nell'array}
int main(void) { int elenco[] = {2, 4, 5, 8, 12, 15, 18, 21, 24, 27}; int n = 10; int chiave = 24;
int pos = ricerca_dicotomica(elenco, n, chiave);
if (pos != -1) { printf("Trovato! Il valore %d si trova all'indice: %d\n", chiave, pos); } else { printf("Valore %d non trovato.\n", chiave); } return 0;}4.3 Analisi quantitativa dell’efficienza
Sezione intitolata “4.3 Analisi quantitativa dell’efficienza”Vediamo numericamente perché la ricerca dicotomica è una svolta ingegneristica per la CPU. Supponiamo di cercare una chiave in un array ordinato contenente esattamente elementi (circa 1 milione).
- Con la Ricerca Lineare, nel caso peggiore la CPU eseguirà 1.048.576 confronti.
- Con la Ricerca Dicotomica, la dimensione dell’area si dimezza ad ogni passo: Poiché , la ricerca si concluderà in al massimo 20 confronti.
Passare da 1 milione di operazioni a solo 20 riduce drasticamente l’utilizzo di energia, tempo e risorse di calcolo della CPU, rendendo la ricerca dicotomica incredibilmente efficiente su grandi moli di dati.
📝 Quiz di Auto-valutazione
Sezione intitolata “📝 Quiz di Auto-valutazione”1. Qual è la precondizione essenziale per poter applicare la ricerca dicotomica (Binary Search) su un array?
- A) L’array deve essere allocato dinamicamente nello Heap.
- B) L’array deve essere preventivamente ordinato.
- C) L’array deve contenere solo numeri positivi.
- D) L’array non deve contenere duplicati.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: La ricerca dicotomica si basa sulla certezza matematica che, confrontando la chiave con l’elemento centrale mid, se arr[mid] < chiave, allora la chiave non può risiedere nella metà sinistra. Questo principio crolla se gli elementi non sono ordinati.
2. Quale delle seguenti formule previene il bug di overflow aritmetico nel calcolo del punto medio?
- A)
(low + high) / 2 - B)
low + (high - low) / 2 - C)
high - (high - low) / 2 - D)
(low / 2) + (high / 2)
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Se low e high sono molto grandi, la loro somma low + high può superare il massimo numero intero rappresentabile (), andando in overflow (diventando negativa). La sottrazione high - low è invece sempre minore del massimo indice ed è quindi sicura.
3. Nel Selection Sort, quante operazioni fisiche di swap vengono eseguite al massimo in un array di elementi?
- A)
- B)
- C)
- D) Nessuna, non usa swap.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Il Selection Sort effettua al massimo uno swap per ogni iterazione del ciclo esterno. Poiché il ciclo esterno viene eseguito volte, il numero massimo di swap eseguiti è esattamente . Questa proprietà lo rende ideale quando scrivere in memoria è molto costoso.
4. Che cosa succede nel Bubble Sort ottimizzato se durante una passata completa dell’array non viene eseguito nessuno swap?
- A) L’algoritmo va in loop infinito.
- B) Il flag
scambiatorimanefalsee l’algoritmo termina immediatamente. - C) L’algoritmo ricomincia dall’inizio azzerando gli indici.
- D) Viene generato un errore a runtime.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Se non avviene alcuno scambio, significa che ogni elemento dell’array è già minore o uguale al suo successore. Il flag scambiato (inizializzato a false) non viene alterato, e la condizione if (!scambiato) forza l’uscita anticipata dal ciclo (break).
5. Qual è la caratteristica distintiva del meccanismo di Insertion Sort rispetto a Bubble e Selection Sort?
- A) Non esegue confronti tra elementi.
- B) Sposta gli elementi tramite slittamento progressivo (shifting) anziché swap continui.
- C) Funziona solo su stringhe e non su interi.
- D) Richiede un array ausiliario per copiare i dati.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: L’Insertion Sort estrae temporaneamente l’elemento corrente in temp e fa slittare a destra di una posizione tutti gli elementi ordinati maggiori di esso. Non esegue scambi bidirezionali continui (swap), riducendo le scritture in RAM.
6. Se cerchiamo un elemento inesistente in un array ordinato di 4096 elementi con la ricerca dicotomica, quanti confronti faremo al massimo?
- A) 4096
- B) 2048
- C) 12
- D) 7
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Poiché ad ogni passo l’area di ricerca viene divisa per due, cerchiamo il più piccolo esponente tale che . Dato che , l’algoritmo eseguirà al massimo 12 confronti.
7. Qual è lo scenario peggiore (worst-case) per il Bubble Sort non ottimizzato?
- A) Array già ordinato in senso crescente.
- B) Array ordinato in senso decrescente (inverso).
- C) Array contenente solo elementi identici.
- D) Array vuoto.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Se l’array è ordinato al contrario, ogni singolo confronto richiederà uno swap per far risalire l’elemento adiacente. L’algoritmo dovrà effettuare il numero massimo di scambi fisici possibili.
8. Nella funzione swap(int *a, int *b), perché è necessario passare gli indirizzi delle variabili (puntatori)?
- A) Perché il C passa i parametri per valore (copia), quindi senza puntatori modificheremmo solo copie locali delle variabili.
- B) Perché i puntatori rendono l’esecuzione più lenta ma sicura.
- C) Perché lo Stack Frame non permette di scambiare variabili locali.
- D) Perché è imposto dalla sintassi delle funzioni di ordinamento.
▶ Mostra Risposta Corretta
Risposta corretta: A
Spiegazione: Il passaggio dei parametri in C avviene per valore. Se passassimo direttamente swap(x, y), la funzione scambierebbe i valori all’interno dei suoi parametri locali a e b, lasciando del tutto inalterate le variabili originali x e y del chiamante.
9. Quale algoritmo tra Selection, Bubble e Insertion Sort si adatta meglio ad ordinare elementi che vengono inseriti in tempo reale uno alla volta?
- A) Selection Sort, perché cerca il minimo.
- B) Bubble Sort, perché fa risalire le bollicine.
- C) Insertion Sort, perché inserisce l’elemento al posto giusto slittando solo il necessario.
- D) Nessuno di essi.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: L’Insertion Sort assume che la porzione a sinistra sia già ordinata. Se arriva un nuovo elemento in coda, basta farlo slittare all’indietro fino alla sua corretta collocazione. È l’approccio ideale per l’ordinamento “in-place” online.
10. Che cosa restituisce la funzione ricerca_dicotomica se la chiave cercata è presente più volte nell’array ordinato?
- A) L’indice della prima occorrenza in assoluto.
- B) L’indice dell’ultima occorrenza.
- C) Un indice arbitrario tra le occorrenze della chiave (dipendente da dove si ferma
mid). - D) Ritorna
-1per errore.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: La Binary Search standard si ferma non appena trova arr[mid] == chiave. Se ci sono duplicati, l’indice restituito dipenderà da quale occorrenza si trova ad essere colpita per prima dal punto medio mid. Per trovare la prima o l’ultima occorrenza servono varianti specifiche dell’algoritmo.
💻 Esercizi Pratici
Sezione intitolata “💻 Esercizi Pratici”Esercizio 1: Trova l’Indice del Minimo
Sezione intitolata “Esercizio 1: Trova l’Indice del Minimo”Scrivete una funzione C int trova_minimo(int arr[], int start, int end) che restituisca l’indice dell’elemento minimo presente nell’array tra le posizioni start ed end (inclusi).
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int trova_minimo(int arr[], int start, int end) {    int idx_min = start;    for (int i = start + 1; i <= end; i++) {        if (arr[i] < arr[idx_min]) {            idx_min = i; // Aggiorna l'indice del minimo        }    }    return idx_min;}
int main(void) {    int vett[] = {9, 4, 2, 7, 5, 1, 8};    // Cerca il minimo tra l'indice 1 e l'indice 5 (valori da 4 a 1)    int pos = trova_minimo(vett, 1, 5);    printf("Il minimo tra gli indici 1 e 5 si trova all'indice %d (valore: %d)\n", pos, vett[pos]);    return 0;}
Spiegazione dell’algoritmo:
Inizializziamo l’indice del minimo con il valore di partenza start. Scansioniamo l’array con un ciclo da start + 1 a end. Se troviamo un valore inferiore a quello puntato da idx_min, aggiorniamo idx_min. Al termine restituiamo l’indice.
Esercizio 2: Bubble Sort Decrescente
Sezione intitolata “Esercizio 2: Bubble Sort Decrescente”Modificate l’algoritmo del Bubble Sort per ordinare l’array in ordine decrescente (dal più grande al più piccolo).
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdbool.h>
void swap(int *a, int *b) {    int temp = *a;    *a = *b;    *b = temp;}
void bubble_sort_decrescente(int arr[], int n) {    bool scambiato;    for (int i = 0; i < n - 1; i++) {        scambiato = false;        for (int j = 0; j < n - i - 1; j++) {            // Per ordinare in modo decrescente, scambiamo se l'elemento di sinistra è MINORE di quello a destra            if (arr[j] < arr[j + 1]) {                swap(&arr[j], &arr[j + 1]);                scambiato = true;            }        }        if (!scambiato) break;    }}
int main(void) {    int vett[] = {3, 1, 4, 5, 2};    bubble_sort_decrescente(vett, 5);    printf("Decrescente: ");    for(int i = 0; i < 5; i++) {        printf("%d ", vett[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo:
Per invertire l’ordine dell’ordinamento è sufficiente invertire la condizione del confronto all’interno del ciclo interno: modificando arr[j] > arr[j + 1] in arr[j] < arr[j + 1], facciamo risalire a destra i valori più piccoli, spingendo a sinistra i valori più grandi.
Esercizio 3: Conta Confronti e Scambi nel Selection Sort
Sezione intitolata “Esercizio 3: Conta Confronti e Scambi nel Selection Sort”Implementate una versione del Selection Sort che tenga traccia del numero totale di confronti effettuati tra elementi e del numero di swap eseguiti, stampando i risultati alla fine.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
void selection_sort_tracciato(int arr[], int n) {    int confronti = 0;    int scambi = 0;
    for (int i = 0; i < n - 1; i++) {        int min_idx = i;        for (int j = i + 1; j < n; j++) {            confronti++;            if (arr[j] < arr[min_idx]) {                min_idx = j;            }        }        if (min_idx != i) {            int temp = arr[i];            arr[i] = arr[min_idx];            arr[min_idx] = temp;            scambi++;        }    }    printf("Confronti eseguiti: %d\n", confronti);    printf("Swap eseguiti: %d\n", scambi);}
int main(void) {    int vett[] = {4, 2, 5, 1, 3};    selection_sort_tracciato(vett, 5);    return 0;}
Spiegazione dell’algoritmo:
Incrementiamo la variabile confronti ad ogni esecuzione della condizione if del ciclo interno e incrementiamo scambi solo all’interno del blocco condizionale if (min_idx != i) che esegue lo swap. Su 5 elementi disordinati vedremo 10 confronti e al massimo 4 swap.
Esercizio 4: Bubble Sort Bidirezionale (Cocktail Shaker Sort)
Sezione intitolata “Esercizio 4: Bubble Sort Bidirezionale (Cocktail Shaker Sort)”Scrivete una variante del Bubble Sort che esegua passate alternate: una da sinistra verso destra (portando il massimo a destra) e una da destra verso sinistra (portando il minimo a sinistra).
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdbool.h>
void swap(int *a, int *b) {    int temp = *a;    *a = *b;    *b = temp;}
void cocktail_sort(int arr[], int n) {    bool scambiato = true;    int start = 0;    int end = n - 1;
    while (scambiato) {        scambiato = false;
        // Passata da sinistra a destra (Bubble Sort classico)        for (int i = start; i < end; i++) {            if (arr[i] > arr[i + 1]) {                swap(&arr[i], &arr[i + 1]);                scambiato = true;            }        }
        // Se non ci sono stati scambi, l'array è ordinato        if (!scambiato) break;
        // Riduciamo end perché l'elemento massimo è congelato a destra        end--;
        scambiato = false;
        // Passata da destra a sinistra        for (int i = end - 1; i >= start; i--) {            if (arr[i] > arr[i + 1]) {                swap(&arr[i], &arr[i + 1]);                scambiato = true;            }        }
        // Incrementiamo start perché il minimo è congelato a sinistra        start++;    }}
int main(void) {    int vett[] = {5, 1, 4, 2, 3};    cocktail_sort(vett, 5);    printf("Ordinato: ");    for(int i = 0; i < 5; i++) {        printf("%d ", vett[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo: Chiamato anche Cocktail Shaker Sort, questo approccio ottimizza il Bubble Sort riducendo il problema degli elementi piccoli situati in fondo a destra (chiamati “tartarughe”), che impiegherebbero molto tempo a risalire a sinistra in passate unidirezionali.
Esercizio 5: Ricerca Lineare di Tutte le Occorrenze
Sezione intitolata “Esercizio 5: Ricerca Lineare di Tutte le Occorrenze”Scrivete una funzione int cerca_tutte(int arr[], int n, int chiave, int indici[]) che cerchi una chiave in un array disordinato e salvi tutti gli indici in cui compare all’interno dell’array indici. La funzione deve restituire il numero totale di occorrenze trovate.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int cerca_tutte(int arr[], int n, int chiave, int indici[]) {    int contatore = 0;    for (int i = 0; i < n; i++) {        if (arr[i] == chiave) {            indici[contatore] = i; // Salva l'indice corrente            contatore++;        }    }    return contatore; // Restituisce il numero totale}
int main(void) {    int vett[] = {4, 2, 5, 2, 3, 2, 8};    int ris[7]; // Vettore per salvare gli indici trovati    int occorrenze = cerca_tutte(vett, 7, 2, ris);
    printf("Trovate %d occorrenze del valore 2 agli indici: ", occorrenze);    for(int i = 0; i < occorrenze; i++) {        printf("%d ", ris[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo:
Scorriamo l’array cella per cella. Quando arr[i] è uguale alla chiave, salviamo il valore dell’indice i nella posizione contatore dell’array di output indici e incrementiamo contatore.
Esercizio 6: Inserimento Ordinato
Sezione intitolata “Esercizio 6: Inserimento Ordinato”Scrivete una funzione void inserimento_ordinato(int arr[], int *n, int max_size, int valore) che inserisca un nuovo valore all’interno di un array già ordinato di dimensione logica *n, spostando gli elementi necessari per preservare l’ordinamento. La dimensione logica dell’array deve essere incrementata tramite il puntatore.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
void inserimento_ordinato(int arr[], int *n, int max_size, int valore) {    // Controllo se c'è spazio fisico nell'array    if (*n >= max_size) {        printf("Errore: array pieno!\n");        return;    }
    int j = *n - 1;    // Slitta gli elementi a destra finché sono maggiori del valore da inserire    while (j >= 0 && arr[j] > valore) {        arr[j + 1] = arr[j];        j--;    }
    // Inserisce il valore nella posizione liberata    arr[j + 1] = valore;    // Incrementa la dimensione logica puntata    (*n)++;}
int main(void) {    int vett[10] = {2, 4, 7, 8, 12};    int n = 5; // Dimensione logica iniziale
    inserimento_ordinato(vett, &n, 10, 5);
    printf("Array dopo inserimento ordinato di 5: ");    for (int i = 0; i < n; i++) {        printf("%d ", vett[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo:
Questo algoritmo è una singola passata del ciclo interno dell’Insertion Sort. Partiamo dalla fine dell’array (*n - 1) e facciamo slittare a destra gli elementi maggiori del nuovo valore, inserendolo poi nello spazio vuoto.
Esercizio 7: Ricerca Dicotomica Ricorsiva
Sezione intitolata “Esercizio 7: Ricerca Dicotomica Ricorsiva”Riscrivete l’algoritmo della ricerca dicotomica in modalità ricorsiva sfruttando i parametri di frontiera low e high.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int ricerca_dicotomica_ricorsiva(int arr[], int low, int high, int chiave) {    // Caso base: area di ricerca esaurita    if (low > high) {        return -1;    }
    int mid = low + (high - low) / 2;
    if (arr[mid] == chiave) {        return mid; // Trovato!    }
    if (arr[mid] > chiave) {        // Cerca nella metà sinistra        return ricerca_dicotomica_ricorsiva(arr, low, mid - 1, chiave);    } else {        // Cerca nella metà destra        return ricerca_dicotomica_ricorsiva(arr, mid + 1, high, chiave);    }}
int main(void) {    int elenco[] = {2, 4, 5, 8, 12, 15, 18, 21, 24, 27};    int pos = ricerca_dicotomica_ricorsiva(elenco, 0, 9, 24);    printf("Indice trovato ricorsivamente: %d\n", pos);    return 0;}
Spiegazione dell’algoritmo:
Se low > high, l’elemento non è presente (caso base di fallimento). Altrimenti calcoliamo mid e confrontiamo. Se arr[mid] è maggiore della chiave, richiamiamo ricorsivamente la funzione restringendo l’intervallo a [low, mid - 1], altrimenti lo restringiamo a [mid + 1, high].
Esercizio 8: Selection Sort su Array di Float
Sezione intitolata “Esercizio 8: Selection Sort su Array di Float”Adattate la funzione del Selection Sort per ordinare un array di numeri reali in virgola mobile (float).
💻 Mostra Soluzione e Codice C
#include <stdio.h>
void selection_sort_float(float arr[], int n) {    for (int i = 0; i < n - 1; i++) {        int min_idx = i;        for (int j = i + 1; j < n; j++) {            if (arr[j] < arr[min_idx]) {                min_idx = j;            }        }        if (min_idx != i) {            float temp = arr[i];            arr[i] = arr[min_idx];            arr[min_idx] = temp;        }    }}
int main(void) {    float vett[] = {3.14, 1.41, 2.71, 0.707, 1.618};    selection_sort_float(vett, 5);
    printf("Float ordinati: ");    for(int i = 0; i < 5; i++) {        printf("%.3f ", vett[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo:
L’algoritmo rimane strutturalmente identico. È stato sufficiente modificare la dichiarazione del tipo del parametro formale dell’array (float arr[]) e della variabile temporanea all’interno dello swap (float temp).
Esercizio 9: Rimozione dei Duplicati in un Array Ordinato
Sezione intitolata “Esercizio 9: Rimozione dei Duplicati in un Array Ordinato”Scrivete una funzione int rimuovi_duplicati(int arr[], int n) che prenda un array già ordinato e rimuova gli elementi duplicati in situ (senza vettori ausiliari). La funzione deve restituire la nuova dimensione logica dell’array.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int rimuovi_duplicati(int arr[], int n) {    if (n == 0 || n == 1) return n;
    int j = 0; // Indice per memorizzare gli elementi unici    for (int i = 0; i < n - 1; i++) {        // Se l'elemento corrente è diverso dal successivo, lo salviamo        if (arr[i] != arr[i + 1]) {            arr[j] = arr[i];            j++;        }    }    // Salva l'ultimo elemento che non è stato confrontato nel ciclo    arr[j] = arr[n - 1];    j++;
    return j; // Nuova dimensione logica}
int main(void) {    int dati[] = {1, 1, 2, 2, 3, 4, 4, 5};    int n = 8;    int nuova_dim = rimuovi_duplicati(dati, n);
    printf("Array senza duplicati (%d elementi): ", nuova_dim);    for (int i = 0; i < nuova_dim; i++) {        printf("%d ", dati[i]);    }    printf("\n");    return 0;}
Spiegazione dell’algoritmo:
Sfruttiamo l’ordinamento: gli elementi uguali sono adiacenti. Scorriamo il vettore confrontando arr[i] con arr[i+1]. Se sono diversi, spostiamo arr[i] all’indice j (che tiene traccia della porzione senza duplicati) e avanziamo j.
Esercizio 10: Ricerca Dicotomica con Verifica Indici Limite
Sezione intitolata “Esercizio 10: Ricerca Dicotomica con Verifica Indici Limite”Scrivete una variante di ricerca_dicotomica che, se la chiave è presente più volte, garantisca di restituire l’indice della prima occorrenza (quella più a sinistra) all’interno dell’array.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int prima_occorrenza_dicotomica(int arr[], int n, int chiave) {    int low = 0;    int high = n - 1;    int ris = -1; // Memorizza la posizione temporanea
    while (low <= high) {        int mid = low + (high - low) / 2;
        if (arr[mid] == chiave) {            ris = mid;      // Trovata! Memorizziamo l'indice            high = mid - 1; // Continuiamo a cercare a SINISTRA per trovare occorrenze precedenti        } else if (arr[mid] < chiave) {            low = mid + 1;        } else {            high = mid - 1;        }    }    return ris;}
int main(void) {    // Array ordinato con duplicati del valore 12    int elenco[] = {2, 4, 12, 12, 12, 15, 18, 21};    int pos = prima_occorrenza_dicotomica(elenco, 8, 12);    printf("La prima occorrenza di 12 si trova all'indice: %d\n", pos); // Deve stampare 2    return 0;}
Spiegazione dell’algoritmo:
Quando troviamo arr[mid] == chiave, anziché fermarci restituendo subito mid, salviamo questo indice in una variabile di appoggio ris e forziamo la ricerca a procedere nella metà sinistra restringendo il range di ricerca con high = mid - 1. Se non ci sono altre occorrenze, la ricerca terminerà restituendo l’ultima salvata in ris.