Lezione 15: Liste Concatenate Semplici
Fino ad oggi abbiamo memorizzato collezioni di elementi contigui in memoria fisica (RAM) attraverso gli array statici e dinamici. Sebbene gli array garantiscano tempi di accesso immediati in tempo costante grazie al calcolo dell’offset dall’indice di partenza, essi presentano rigidi limiti strutturali:
- Costo di ridimensionamento: Se lo spazio allocato nello Heap tramite
mallocoreallocsi esaurisce, l’ingrandimento dell’array può comportare la ricerca di una nuova area di memoria contigua sufficientemente capiente, costringendo la CPU a copiare interamente i dati esistenti (). - Costo di inserimento/eliminazione in posizione intermedia: Inserire o rimuovere un valore all’indice 0 richiede lo scorrimento (shifting) di tutti gli elementi successivi verso destra o verso sinistra, con una complessità pari a .
La Lista Concatenata Semplice (Singly Linked List) supera questi limiti rinunciando alla contiguità fisica degli elementi.
1. La Struttura Logica della Lista
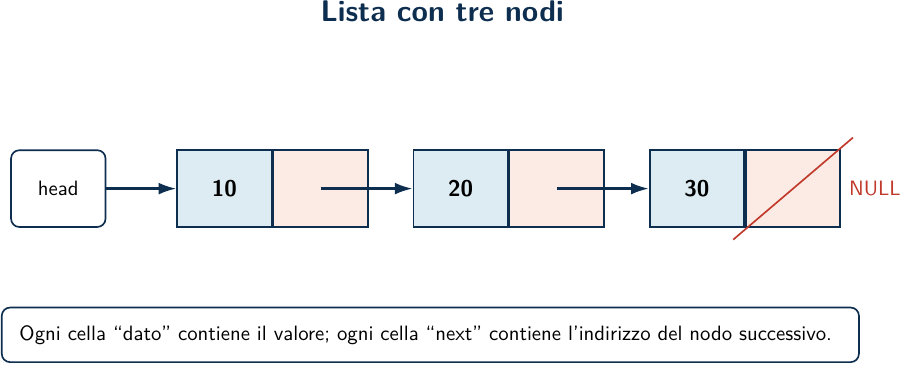
Sezione intitolata “1. La Struttura Logica della Lista”In una lista concatenata, gli elementi (chiamati Nodi) sono distribuiti liberamente all’interno dello Heap. Essi sono logicamente collegati tramite indirizzi di memoria (puntatori).
1.1 L’Anatomia di un Nodo
Sezione intitolata “1.1 L’Anatomia di un Nodo”Ogni nodo è un record (struct) costituito da due campi fondamentali:
- Payload (Dato): Le informazioni effettivamente memorizzate (ad esempio, un intero
int, un carattere o una struttura nidificata). - Puntatore al Successore (
next): Un puntatore contenente l’indirizzo di memoria del nodo successivo nella sequenza.
Per gestire una lista concatenata, il programmatore deve mantenere una variabile locale nello Stack chiamata Puntatore di Testa (head), la quale contiene l’indirizzo di memoria del primo nodo.
2. Rappresentazione in C ed Ispezione
Sezione intitolata “2. Rappresentazione in C ed Ispezione”Definiamo il nodo in C mediante una struttura auto-referenziale (una struct che contiene un puntatore a un’altra istanza della stessa struct):
typedef struct Nodo { int dato; struct Nodo *prossimo;} Nodo;2.1 Funzione di Allocazione Sicura
Sezione intitolata “2.1 Funzione di Allocazione Sicura”Per evitare di scrivere ripetutamente codice di allocazione nello Heap con gestione degli errori, implementiamo una funzione helper per creare nodi isolati:
Nodo* crea_nodo(int valore) { Nodo *nuovo = (Nodo*) malloc(sizeof(Nodo)); if (nuovo == NULL) { fprintf(stderr, "Errore fatale: memoria Heap esaurita.\n"); exit(EXIT_FAILURE); } nuovo->dato = valore; nuovo->prossimo = NULL; // Nasce scollegato return nuovo;}Appea creata, la lista è composta solo della testa ed è dunque vuota, come mostrato nell’immagine seguente:
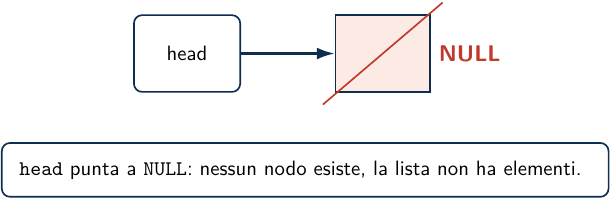
Possiamo verificare se una lista è vuota mediante la seguente funzione:
bool is_empty(Nodo *testa) { return testa == NULL;}2.2 Scorrimento Sequenziale e Stampa
Sezione intitolata “2.2 Scorrimento Sequenziale e Stampa”Per scorrere la lista, non possiamo ricorrere ad indici numerici diretti. Dobbiamo usare un puntatore ausiliario (convenzionalmente chiamato corrente o curr) posizionato inizialmente sulla testa, facendolo avanzare progressivamente aggiornando il suo indirizzo con il valore salvato nel campo prossimo.
void stampa_lista(Nodo *testa) { Nodo *corrente = testa; printf("Testa -> "); while (corrente != NULL) { printf("[%d] -> ", corrente->dato); corrente = corrente->prossimo; // Passo di avanzamento } printf("NULL\n");}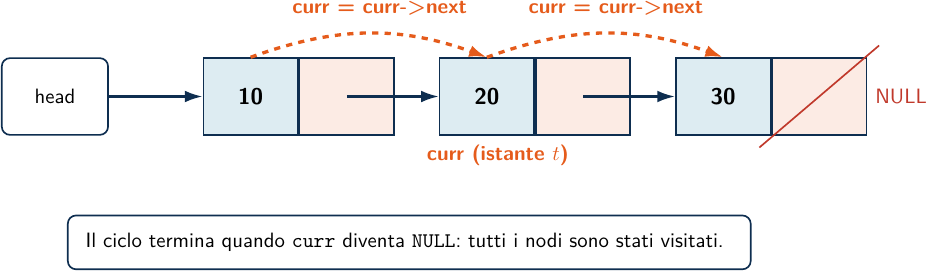
2.3 Ricerca di un Elemento
Sezione intitolata “2.3 Ricerca di un Elemento”La ricerca in una lista concatenata non ordinata è intrinsecamente lineare e richiede di scorrere i nodi uno ad uno:
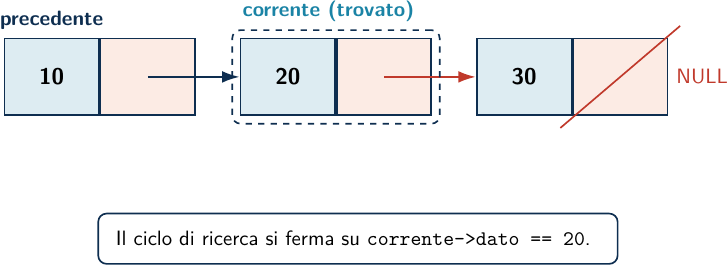
bool cerca_elemento(Nodo *testa, int chiave, Nodo **nodo_trovato) { Nodo *corrente = testa; while (corrente != NULL) { if (corrente->dato == chiave) { if (nodo_trovato != NULL) { *nodo_trovato = corrente; } return true; } corrente = corrente->prossimo; } if (nodo_trovato != NULL) { *nodo_trovato = NULL; } return false;}Quando non si conosce già la posizione del nodo, si scorre la lista con due puntatori, precedente e corrente, finché corrente->dato non corrisponde al valore cercato; poi si applica la stessa logica di detach.
3. La Chirurgia dei Puntatori: Inserimenti
Sezione intitolata “3. La Chirurgia dei Puntatori: Inserimenti”L’inserimento di elementi in una lista non richiede mai lo spostamento fisico dei nodi in memoria, bensì la riconfigurazione locale delle connessioni dei puntatori.
3.1 Inserimento in Testa
Sezione intitolata “3.1 Inserimento in Testa”Inserire in testa è un’operazione che richiede tempo costante:
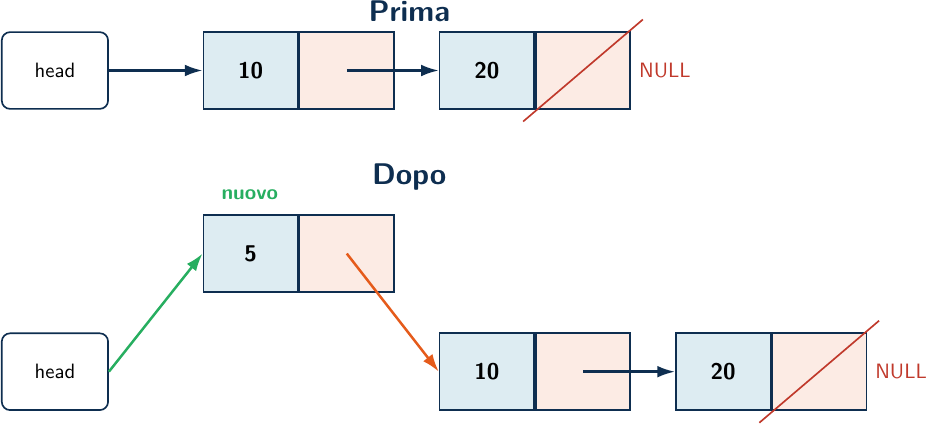
- Si alloca un nuovo nodo.
- Si fa puntare il campo
prossimodel nuovo nodo alla vecchia testa. - Si aggiorna il puntatore di testa affinché contenga l’indirizzo del nuovo nodo.
Nodo* inserisci_testa(Nodo *testa, int valore) { Nodo *nuovo = crea_nodo(valore); nuovo->prossimo = testa; return nuovo; // Diventa la nuova testa}Nelle figure sottostanti viene mostrato il passaggio dall’allocazione isolata del nuovo nodo all’aggancio definitivo.
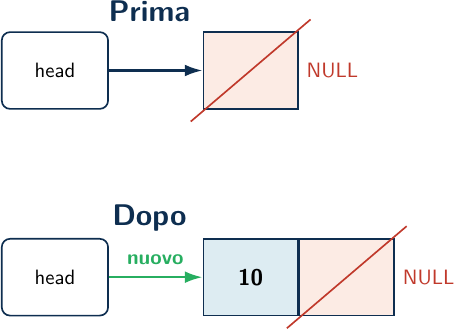
Il codice sopra funziona anche nel caso speciale in cui inseriamo un elemento in una lista vuota:
3.2 Inserimento in Coda
Sezione intitolata “3.2 Inserimento in Coda”Per inserire un elemento in fondo alla lista, è necessario individuare l’ultimo nodo (ovvero il nodo che punta a NULL), modificando il suo campo prossimo affinché punti al nuovo nodo.
- Se la lista è vuota (), il nuovo nodo diventa direttamente la testa.
- Se la lista contiene elementi, si effettua una scansione lineare per posizionarsi sull’ultimo elemento.
Nodo* inserisci_coda(Nodo *testa, int valore) { Nodo *nuovo = crea_nodo(valore); if (testa == NULL) { return nuovo; } Nodo *corrente = testa; while (corrente->prossimo != NULL) { corrente = corrente->prossimo; } corrente->prossimo = nuovo; return testa;}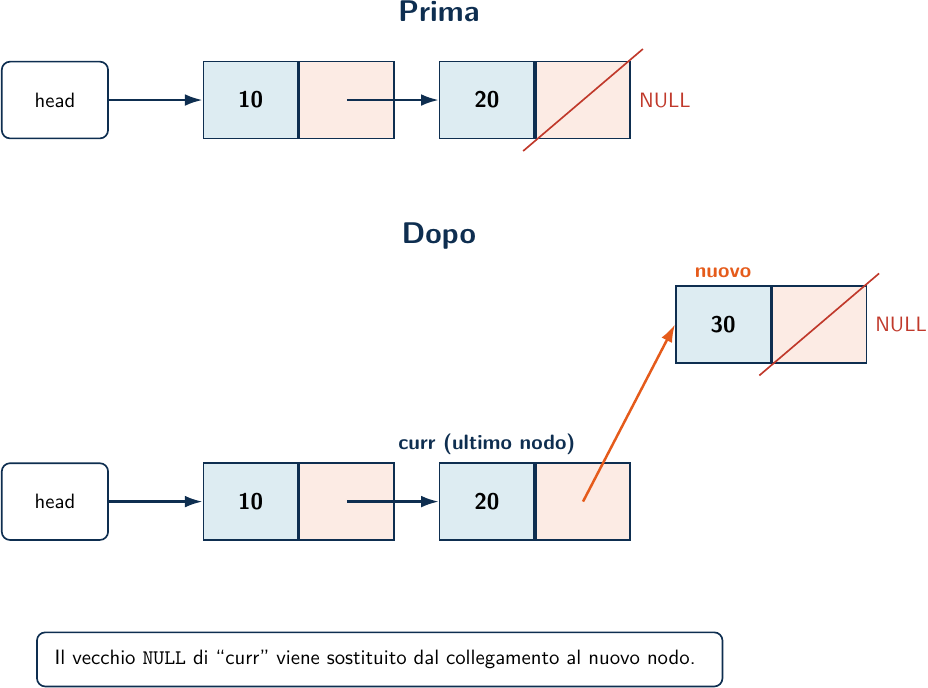
3.3 Inserimento Ordinato
Sezione intitolata “3.3 Inserimento Ordinato”L’inserimento ordinato in una lista crescente richiede di trovare la posizione esatta in mezzo a due nodi esistenti.
Poiché la lista semplice è a senso unico, una volta superato il punto di inserimento non è possibile tornare indietro per aggiornare il puntatore del nodo che precede. Per risolvere questo problema, si utilizza la tecnica dei due puntatori sfalsati (precedente e corrente).
Nodo* inserisci_ordinato(Nodo *testa, int valore) {    Nodo *nuovo = crea_nodo(valore);
    // Caso 1: Lista vuota o inserimento in testa    if (testa == NULL || valore < testa->dato) {        nuovo->prossimo = testa;        return nuovo;    }
    // Caso 2: Ricerca della posizione intermedia    Nodo *precedente = testa;    Nodo *corrente = testa->prossimo;
    while (corrente != NULL && corrente->dato < valore) {        precedente = corrente;        corrente = corrente->prossimo;    }
    // Chirurgia di collegamento    precedente->prossimo = nuovo;    nuovo->prossimo = corrente;
    return testa;}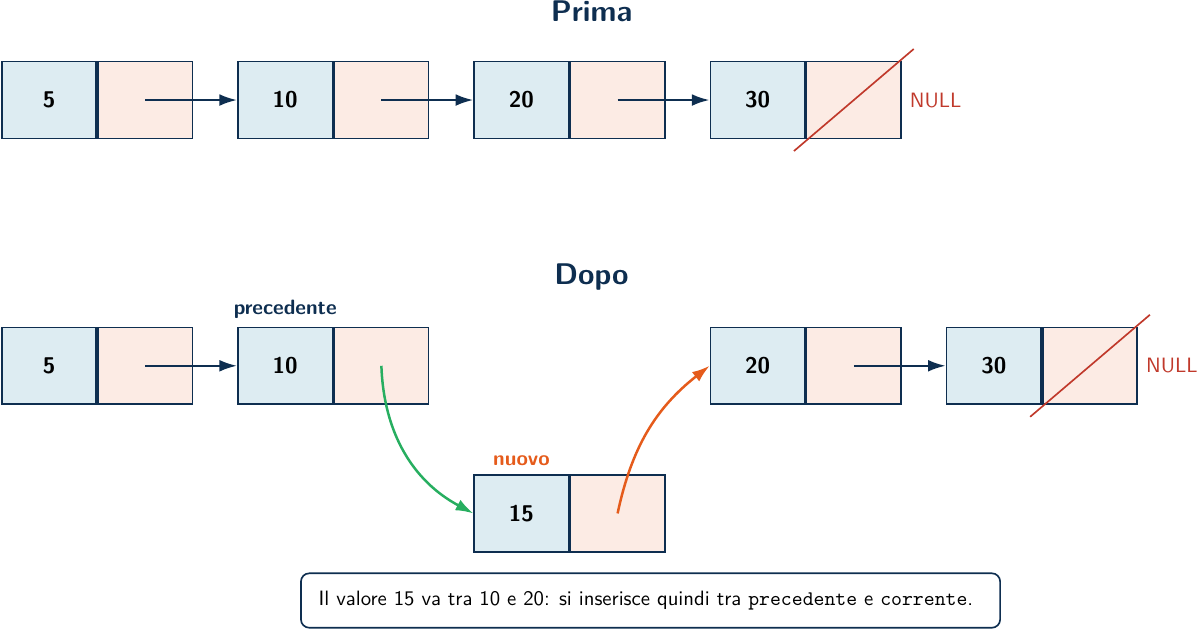
4. La Chirurgia dei Puntatori: Cancellazioni
Sezione intitolata “4. La Chirurgia dei Puntatori: Cancellazioni”La rimozione di un nodo richiede di bypassarlo (scavalcarlo) modificando il puntatore del nodo precedente, ed eliminando fisicamente l’elemento dallo Heap tramite free.
Pericolo di Memory Leak
È tassativo salvare l’indirizzo del nodo da eliminare in un puntatore di supporto prima di modificare le connessioni. Se si effettua la free del nodo senza preservare il suo campo prossimo, si perde il collegamento con tutti i nodi successivi, rendendoli orfani e inaccessibili nello Heap.
4.1 Cancellazione in Testa
Sezione intitolata “4.1 Cancellazione in Testa”Nodo* rimuovi_testa(Nodo *testa) { if (testa == NULL) return NULL;
Nodo *da_liberare = testa; // Salvataggio riferimento testa = testa->prossimo; // Spostamento testa free(da_liberare); // Rimozione sicura return testa;}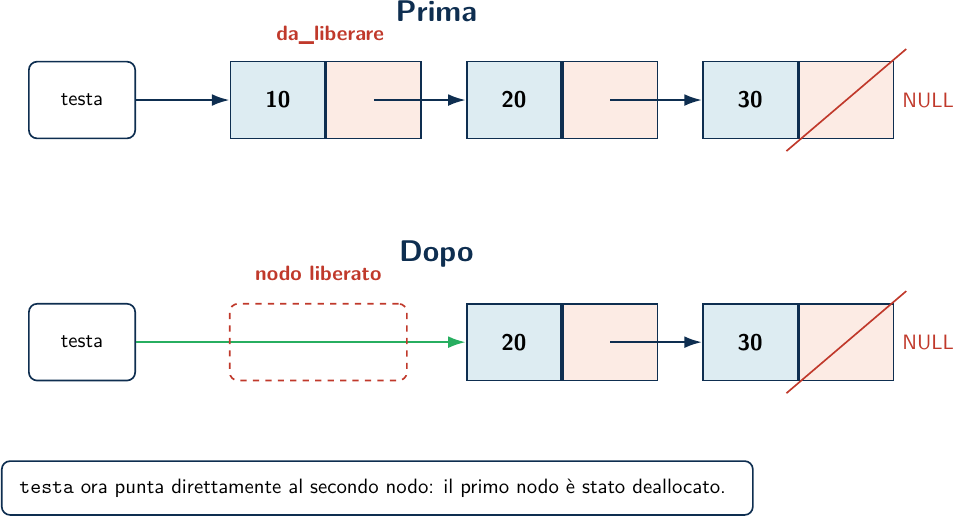
4.2 Cancellazione in Coda
Sezione intitolata “4.2 Cancellazione in Coda”Per rimuovere l’ultimo elemento della lista, occorre scorrere l’intera lista per posizionarsi sul penultimo nodo. Una volta individuato il penultimo nodo, si imposta il suo campo prossimo a NULL e si libera la memoria dell’ultimo nodo.
Nodo* rimuovi_coda(Nodo *testa) {    if (testa == NULL) return NULL;
    // Se c'è solo un nodo    if (testa->prossimo == NULL) {        free(testa);        return NULL;    }
    Nodo *precedente = NULL;    Nodo *corrente = testa;    while (corrente->prossimo != NULL) {        precedente = corrente;        corrente = corrente->prossimo;    }    precedente->prossimo = NULL;    free(corrente);    return testa;}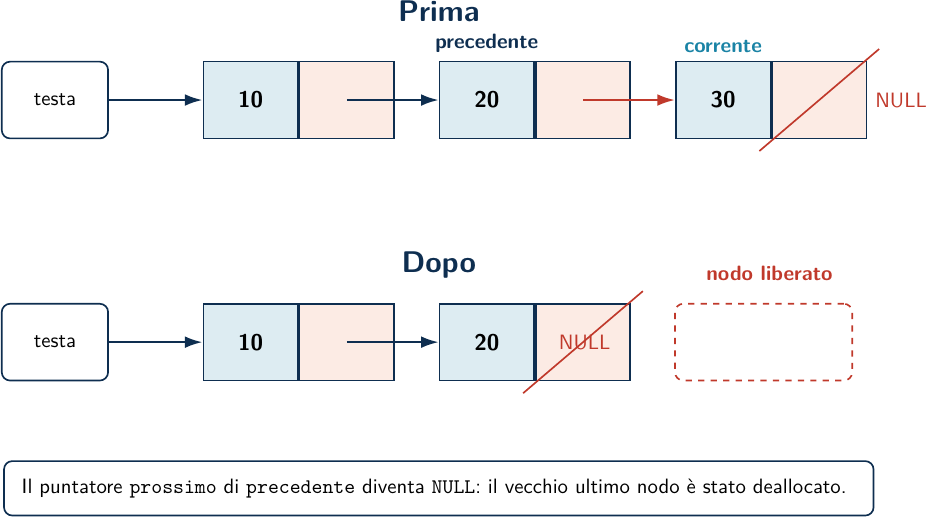
4.3 Cancellazione di un Elemento Specifico
Sezione intitolata “4.3 Cancellazione di un Elemento Specifico”Per rimuovere un nodo contenente un dato valore, si esegue una scansione lineare con due puntatori sfalsati. Una volta individuato il valore, si esegue lo scavallamento del puntatore (precedente->prossimo = corrente->prossimo).
Nodo* rimuovi_valore(Nodo *testa, int valore) {    if (testa == NULL) return NULL;
    // Rimozione in testa    if (testa->dato == valore) {        Nodo *nuova_testa = testa->prossimo;        free(testa);        return nuova_testa;    }
    Nodo *precedente = testa;    Nodo *corrente = testa->prossimo;
    while (corrente != NULL && corrente->dato != valore) {        precedente = corrente;        corrente = corrente->prossimo;    }
    if (corrente != NULL) {        precedente->prossimo = corrente->prossimo; // Detach        free(corrente); // Deallocazione    }
    return testa;}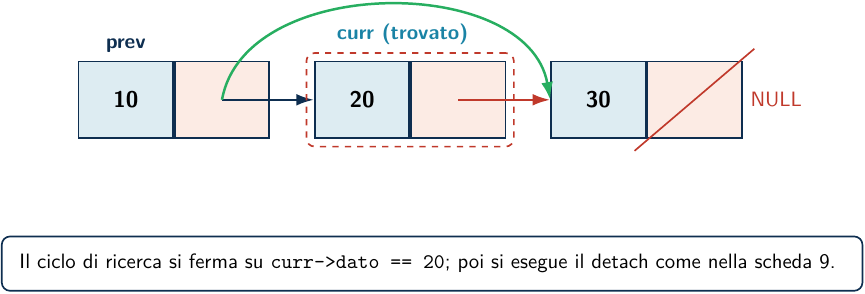
4.4 Deallocazione dell’Intera Lista
Sezione intitolata “4.4 Deallocazione dell’Intera Lista”Sebbene i moderni sistemi operativi liberino in automatico lo spazio di indirizzamento utilizzato da un programma, di fatto liberando lo spazio delle free non effettuate al momento della chiusura del programma, in ambienti di programmazione di basso livello (es. microcontrollori), non liberare la memoria può dare vita a memory leak persistenti anche alla chiusura del programm. Prima del termine del programma, è pertanto buona norma distruggere ogni lista allocata dinamicamente:
void svuota_lista(Nodo *testa) { Nodo *corrente = testa; while (corrente != NULL) { Nodo *successore = corrente->prossimo; // Preserva il futuro free(corrente); // Dealloca il presente corrente = successore; // Avanza }}4.5 Ordinamento su Liste (Bubble Sort)
Sezione intitolata “4.5 Ordinamento su Liste (Bubble Sort)”Ora che sappiamo navigare e modificare una lista, come facciamo ad ordinarne una nata disordinata? Negli array usavamo il Bubble Sort scambiando gli elementi con un algoritmo di swap. Sulle liste abbiamo due opzioni:
- Opzione A (Swap dei Dati): Copiamo e scambiamo unicamente il valore contenuto nei campi dato dei nodi, lasciando i nodi fisicamente dove si trovano nello Heap.
- Opzione B (Swap dei Puntatori): Sganciamo fisicamente i nodi e riallineiamo i loro puntatori prossimo per scambiarne l’ordine.
La Scelta Ingegneristica
Sezione intitolata “La Scelta Ingegneristica”Scambiare i puntatori (Opzione B) è un’operazione complessa che richiede di aggiornare fino a 4 indirizzi diversi per ogni singolo swap, aumentando drasticamente il rischio di perdere nodi o creare cicli infiniti. Per garantire la stabilità del codice e la semplicità didattica, l’Opzione A (Swap dei Dati) è la scelta ottimale, in quanto ricalca in modo pulito ed intuitivo la logica del Bubble Sort sugli array!
L’algoritmo di Bubble Sort applicato alla Lista
Sezione intitolata “L’algoritmo di Bubble Sort applicato alla Lista”Sostituiamo gli indici numerici [i] e [i+1] con i puntatori di navigazione corrente e corrente->prossimo:
void ordina_lista(Nodo *testa) {    // Caso banale: lista vuota o con un solo elemento (gia' ordinata)    if (testa == NULL || testa->prossimo == NULL) {        return;    }
    bool scambiato;    Nodo *corrente;    Nodo *limite = NULL; // Ottimizzazione: delimita la fine della scansione
    do {        scambiato = false;        corrente = testa;
        // Scorriamo la lista fino al limite degli elementi gia' consolidati        while (corrente->prossimo != limite) {            // Confrontiamo elementi adiacenti sequenziali            if (corrente->dato > corrente->prossimo->dato) {                // LA CHIRURGIA DEL PAYLOAD: Scambio in-place dei dati                int temp = corrente->dato;                corrente->dato = corrente->prossimo->dato;                corrente->prossimo->dato = temp;
                scambiato = true; // Segnaliamo che e' avvenuto uno scambio            }            corrente = corrente->prossimo; // Passo in avanti        }        // L'ultimo elemento esaminato e' ora sicuramente al suo posto corretto        limite = corrente;
    } while (scambiato); // Se non ci sono stati scambi, l'intera lista e' ordinata!}
5. Quiz di Autovalutazione
Sezione intitolata “5. Quiz di Autovalutazione”1. Come si inizializza correttamente una lista vuota in C?
- A) Dichiarando un puntatore a Nodo e assegnandogli il valore
NULL(es.Nodo *testa = NULL;). - B) Allocando subito un nodo vuoto tramite
malloc. - C) Dichiarando una variabile
Nodolocale nello Stack senza inizializzarla. - D) Impostando il valore del primo nodo a
0.
▶ Mostra Risposta Corretta
Risposta corretta: A
Spiegazione: Per indicare che una lista non contiene alcun elemento, il puntatore di testa (testa) deve essere impostato esplicitamente a NULL. Questo evita che contenga indirizzi spazzatura e consente alle funzioni di controllo di rilevarne lo stato vuoto.
2. Qual è l’effetto di perdere l’indirizzo memorizzato nella variabile di testa head?
- A) La lista si inverte automaticamente in memoria.
- B) Un memory leak irreversibile di tutti i nodi della lista.
- C) I nodi vengono deallocati automaticamente dal Garbage Collector di C.
- D) Il programma continua a funzionare regolarmente accedendo tramite indici.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Nello Heap, i nodi sono accessibili unicamente conoscendo l’indirizzo del primo nodo (head). Se questa variabile viene persa o sovrascritta senza prima aver deallocato la memoria, gli indirizzi dei nodi diventano irrintracciabili per la CPU, bloccando quella porzione di RAM fino al termine del processo.
3. Cosa contiene il campo prossimo dell’ultimo nodo di una lista ben formata?
- A) L’indirizzo della testa (
head). - B) Un valore casuale sporco di memoria (garbage value).
- C) Il valore speciale
NULL. - D) L’indirizzo del nodo stesso.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: In C, NULL indica l’assenza di un indirizzo di memoria valido ed è utilizzato come sentinella standard per arrestare i cicli di scorrimento delle liste.
4. Quale operazione sui puntatori è necessaria per inserire un nuovo nodo in testa a una lista non vuota?
- A) Far puntare il campo
prossimodel nuovo nodo aNULLe deallocare la testa. - B) Far puntare il campo
prossimodel nuovo nodo al nodo che era precedentemente in testa, e poi aggiornare il puntatore di testa per farlo puntare al nuovo nodo. - C) Spostare tutti i valori della lista nei nodi adiacenti verso destra.
- D) Modificare l’indirizzo del puntatore di testa lasciando inalterato il campo
prossimodel nuovo nodo.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Per inserire un nodo in testa senza perdere il collegamento con i nodi già esistenti, il nuovo nodo deve prima “agganciarsi” alla vecchia testa salvandone l’indirizzo nel suo campo prossimo. Solo a questo punto possiamo muovere il puntatore di testa sul nuovo nodo.
5. Perché nell’allocazione dinamica di un nodo è importante verificare il valore di ritorno della malloc?
- A) Per evitare memory leaks.
- B) Perché la
mallocrestituisceNULLin caso di memoria Heap esaurita, provocando crash (Segmentation Fault) in caso di mancato controllo. - C) Per verificare che il dato inserito sia di tipo numerico.
- D) Per liberare automaticamente il nodo deallocato in precedenza.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Tentare di dereferenziare un puntatore NULL (es. nuovo->dato = valore quando nuovo è NULL) provoca un crash immediato del programma (Segmentation Fault).
6. Nella funzione inserisci_coda, perché il ciclo di scorrimento si ferma quando corrente->prossimo != NULL anziché corrente != NULL?
- A) Perché altrimenti si verificherebbe un ciclo infinito.
- B) Per evitare di allocare due nodi contemporaneamente.
- C) Perché abbiamo bisogno di fermarci esattamente sull’ultimo nodo per poterne modificare il campo
prossimo. - D) Perché l’ultimo nodo ha il puntatore al dato pari a 0.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Se ci fermassimo quando corrente == NULL, avremmo superato la lista e non avremmo più un nodo valido su cui innestare il puntatore al nuovo elemento.
7. Nella rimozione di un nodo intermedio, perché sono necessari due puntatori (precedente e corrente)?
- A) Per raddoppiare la velocità di esecuzione della cancellazione.
- B) Perché la lista semplice è monodirezionale e serve
precedenteper scavalcarecorrenteuna volta trovato il valore. - C) Per gestire contemporaneamente l’inserimento e la rimozione.
- D) Perché non è possibile usare variabili locali all’interno della funzione.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Una volta posizionati sul nodo da cancellare (corrente), non abbiamo alcun modo di risalire al nodo che lo precede per fare in modo che quest’ultimo “scavalchi” l’elemento rimosso.
8. Che cosa accade se si invoca free(testa) come prima istruzione di una funzione di deallocazione totale della lista?
- A) La memoria viene liberata correttamente e
headviene aggiornato. - B) Si perde l’indirizzo del nodo successivo, impedendo di scorrere e deallocare il resto della lista (causando leak).
- C) Il compilatore segnala un errore di sintassi bloccante.
- D) Tutti i nodi successivi vengono automaticamente spostati nello Stack.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Liberare il nodo distrugge il campo prossimo. Bisogna sempre salvare l’indirizzo del successore in una variabile temporanea prima di deallocare il nodo corrente.
9. Quale delle seguenti dichiarazioni definisce correttamente un tipo nodo autoreferenziale?
- A)
typedef struct { int dato; Nodo *prossimo; } Nodo; - B)
typedef struct Nodo { int dato; struct Nodo *prossimo; } Nodo; - C)
typedef struct Nodo { int dato; Nodo prossimo; } Nodo; - D)
struct Nodo { int dato; struct Nodo prossimo; };
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Il compilatore ha bisogno di conoscere l’esistenza di struct Nodo per dichiarare il puntatore interno prima che la definizione del tipo alias Nodo sia completata.
10. Qual è il principale svantaggio delle liste concatenate rispetto agli array statici?
- A) Il fatto che non possono memorizzare valori negativi.
- B) Mancanza dell’accesso casuale e consumo extra di memoria per memorizzare i puntatori.
- C) L’impossibilità di usare tipi strutturati (es.
struct) come payload del nodo. - D) Il rischio costante di esaurire lo Stack di sistema a causa dell’allocazione dinamica.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Per ogni elemento salvato in lista, occorre consumare dello spazio aggiuntivo in memoria (4 o 8 byte) per salvare l’indirizzo del nodo successivo.
6. Esercizi Pratici Risolti
Sezione intitolata “6. Esercizi Pratici Risolti”Esercizio 1: Conteggio dei Nodi
Sezione intitolata “Esercizio 1: Conteggio dei Nodi”Scrivere una funzione int conta_nodi(Nodo *testa) che restituisca il numero totale di elementi presenti nella lista.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
int conta_nodi(Nodo *testa) {    int conteggio = 0;    Nodo *corrente = testa;    while (corrente != NULL) {        conteggio++;        corrente = corrente->prossimo;    }    return conteggio;}
Esercizio 2: Somma e Media dei Nodi
Sezione intitolata “Esercizio 2: Somma e Media dei Nodi”Scrivere una funzione double media_lista(Nodo *testa) che calcoli la media aritmetica dei valori interi contenuti nei nodi di una lista semplice. Nel caso di lista vuota, la funzione deve restituire 0.0.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
double media_lista(Nodo *testa) {    if (testa == NULL) {        return 0.0;    }    int somma = 0;    int conteggio = 0;    Nodo *corrente = testa;    while (corrente != NULL) {        somma += corrente->dato;        conteggio++;        corrente = corrente->prossimo;    }    return (double)somma / conteggio;}
Esercizio 3: Verifica Presenza Elemento (Ricerca Lineare)
Sezione intitolata “Esercizio 3: Verifica Presenza Elemento (Ricerca Lineare)”Scrivere una funzione bool contiene_valore(Nodo *testa, int target) che restituisca true se il valore target è presente in almeno uno dei nodi della lista, e false altrimenti.
💻 Mostra Soluzione e Codice C
#include <stdbool.h>#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
bool contiene_valore(Nodo *testa, int target) {    Nodo *corrente = testa;    while (corrente != NULL) {        if (corrente->dato == target) {            return true; // Trovato, interruzione anticipata        }        corrente = corrente->prossimo;    }    return false; // Elemento non presente}
Esercizio 4: Inserimento in Testa In-Place (Doppio Puntatore)
Sezione intitolata “Esercizio 4: Inserimento in Testa In-Place (Doppio Puntatore)”Implementare la funzione void inserisci_testa_doppio_ptr(Nodo **testa_ptr, int valore) che inserisce un elemento in testa alla lista modificando direttamente la variabile di testa del chiamante passata tramite riferimento.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
void inserisci_testa_doppio_ptr(Nodo **testa_ptr, int valore) {    Nodo *nuovo = (Nodo*) malloc(sizeof(Nodo));    if (nuovo == NULL) {        exit(EXIT_FAILURE);    }    nuovo->dato = valore;
    // Il nuovo nodo punta al nodo attualmente referenziato dalla testa    nuovo->prossimo = *testa_ptr;
    // Aggiorniamo il valore del puntatore originale nello Stack del chiamante    *testa_ptr = nuovo;}
Esercizio 5: Deallocazione Totale di una Lista
Sezione intitolata “Esercizio 5: Deallocazione Totale di una Lista”Scrivere una funzione void distruggi_lista(Nodo **testa_ptr) che liberi tutta la memoria occupata dai nodi della lista e, al termine, imposti il puntatore originale del chiamante a NULL per evitare puntatori pendenti (dangling pointers).
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
void distruggi_lista(Nodo **testa_ptr) {    if (testa_ptr == NULL) return;
    Nodo *corrente = *testa_ptr;    while (corrente != NULL) {        Nodo *prossimo = corrente->prossimo; // Conserviamo il link futuro        free(corrente);                     // Deallocazione sicura del presente        corrente = prossimo;                // Avanzamento    }
    *testa_ptr = NULL; // Azzera la variabile originale del chiamante}
Analisi algoritmica: Si liberano individualmente gli nodi allocati dinamicamente. Complessità temporale: . Azzerando *testa_ptr garantiamo la sicurezza del codice chiamante che non tenterà di accedere a memoria non più valida.
Esercizio 6: Inversione In-Place di una Lista (Reverse)
Sezione intitolata “Esercizio 6: Inversione In-Place di una Lista (Reverse)”Scrivere una funzione Nodo* inverti_lista(Nodo *testa) che inverta l’ordine dei collegamenti dei nodi in modo che l’ultimo nodo diventi la nuova testa, e il primo nodo punti a NULL. L’operazione deve essere eseguita in-place, ovvero senza allocare nuovi nodi.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
Nodo* inverti_lista(Nodo *testa) {    Nodo *precedente = NULL;    Nodo *corrente = testa;    Nodo *successore = NULL;
    while (corrente != NULL) {        successore = corrente->prossimo; // Salva il resto della lista        corrente->prossimo = precedente; // Inverte la direzione del puntatore        precedente = corrente;           // Avanza precedente        corrente = successore;           // Avanza corrente    }
    return precedente; // Nuova testa della lista invertita}
Esercizio 7: Riconoscimento ed Eliminazione dei Duplicati in Lista Ordinata
Sezione intitolata “Esercizio 7: Riconoscimento ed Eliminazione dei Duplicati in Lista Ordinata”Scrivere una funzione void rimuovi_duplicati_ordinata(Nodo *testa) che, data una lista ordinata in modo crescente, rimuova tutti i nodi duplicati adiacenti mantenendo una sola copia di ciascun valore.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
void rimuovi_duplicati_ordinata(Nodo *testa) {    if (testa == NULL) return;
    Nodo *corrente = testa;    while (corrente->prossimo != NULL) {        if (corrente->dato == corrente->prossimo->dato) {            // Rilevato duplicato adiacente            Nodo *doppione = corrente->prossimo;            corrente->prossimo = doppione->prossimo; // Scavallamento            free(doppione);                         // Rimozione        } else {            corrente = corrente->prossimo; // Avanziamo solo se non c'era duplicato        }    }}
Analisi algoritmica: Poiché la lista è già ordinata, i duplicati sono necessariamente vicini. La scansione richiede tempo ed effettua la free dei soli elementi ridondanti.
Esercizio 8: Unione di Due Liste Ordinate (Merge)
Sezione intitolata “Esercizio 8: Unione di Due Liste Ordinate (Merge)”Scrivere una funzione Nodo* fondi_liste_ordinate(Nodo *l1, Nodo *l2) che prenda in input due liste ordinate in modo crescente e restituisca una terza lista ordinata contenente l’unione dei nodi delle due liste originali. È possibile staccare e riutilizzare i nodi esistenti.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
Nodo* fondi_liste_ordinate(Nodo *l1, Nodo *l2) {    // Casi base se una delle due liste è vuota    if (l1 == NULL) return l2;    if (l2 == NULL) return l1;
    Nodo *nuova_testa = NULL;
    // Determina il primo nodo della nuova lista    if (l1->dato <= l2->dato) {        nuova_testa = l1;        l1 = l1->prossimo;    } else {        nuova_testa = l2;        l2 = l2->prossimo;    }
    Nodo *corrente = nuova_testa;
    // Fonde confrontando gli elementi testa a testa    while (l1 != NULL && l2 != NULL) {        if (l1->dato <= l2->dato) {            corrente->prossimo = l1;            l1 = l1->prossimo;        } else {            corrente->prossimo = l2;            l2 = l2->prossimo;        }        corrente = corrente->prossimo;    }
    // Collega l'eventuale coda rimanente di una delle due liste    if (l1 != NULL) {        corrente->prossimo = l1;    } else {        corrente->prossimo = l2;    }
    return nuova_testa;}
Esercizio 9: Individuazione del Nodo Mediano (Puntatori Veloce e Lento)
Sezione intitolata “Esercizio 9: Individuazione del Nodo Mediano (Puntatori Veloce e Lento)”Implementare una funzione Nodo* trova_mediano(Nodo *testa) che restituisca l’indirizzo di memoria del nodo centrale di una lista semplice senza calcolarne preventivamente la lunghezza totale. Se la lista ha lunghezza pari, si consideri il primo dei due nodi centrali.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
Nodo* trova_mediano(Nodo *testa) {    if (testa == NULL) return NULL;
    Nodo *lento = testa;    Nodo *veloce = testa;
    // Il puntatore veloce cammina al doppio della velocità del lento    while (veloce->prossimo != NULL && veloce->prossimo->prossimo != NULL) {        lento = lento->prossimo;        veloce = veloce->prossimo->prossimo;    }
    return lento; // Quando veloce arriva alla fine, lento è a metà}
Esercizio 10: Concatenazione in Coda di Due Liste (Append)
Sezione intitolata “Esercizio 10: Concatenazione in Coda di Due Liste (Append)”Scrivere una funzione Nodo* concatena_liste(Nodo *l1, Nodo *l2) che colleghi la lista l2 in coda alla lista l1. La funzione deve restituire la testa della nuova lista unificata.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
Nodo* concatena_liste(Nodo *l1, Nodo *l2) {    // Caso speciale: se la prima lista è vuota, restituiamo direttamente la seconda    if (l1 == NULL) {        return l2;    }
    Nodo *corrente = l1;    // Raggiungiamo l'ultimo nodo di l1    while (corrente->prossimo != NULL) {        corrente = corrente->prossimo;    }
    // Aggancio del primo nodo di l2 alla coda di l1    corrente->prossimo = l2;
    return l1;}