Lezione 16: Pile, Code e Liste Doppie
Nelle lezioni precedenti abbiamo visto come memorizzare dati all’interno di strutture lineari come gli array (allocazione contigua in RAM) e le liste concatenate semplici (nodi sparsi nello Heap collegati in avanti). In questa lezione facciamo un passo avanti: separiamo la rappresentazione fisica dei dati dalle regole logiche con cui vi accediamo, introducendo il concetto di Tipo di Dato Astratto (ADT). Studieremo poi come implementare in C due delle strutture dati più importanti dell’informatica, la Pila (Stack) e la Coda (Queue), concludendo con un’introduzione alle Liste Doppiamente Concatenate.
1. Il Concetto di Tipo di Dato Astratto (ADT)
Sezione intitolata “1. Il Concetto di Tipo di Dato Astratto (ADT)”Fino ad ora abbiamo manipolato i dati preoccupandoci di come disporli fisicamente in memoria. Ad esempio, per rappresentare una sequenza di interi, abbiamo usato un array (contiguo) o una lista (frammentata).
Un Tipo di Dato Astratto (Abstract Data Type - ADT) è una descrizione logica di una struttura dati che definisce:
- I dati memorizzati.
- Le operazioni consentite su di essi.
- Le regole con cui è permesso accedere a tali dati.
In un ADT, l’implementazione fisica (array o lista) viene nascosta all’utente esterno dietro un’interfaccia pubblica (un insieme di funzioni). Questo principio di programmazione prende il nome di incapsulamento ed astrazione dei dati.
2. La Pila (Stack)
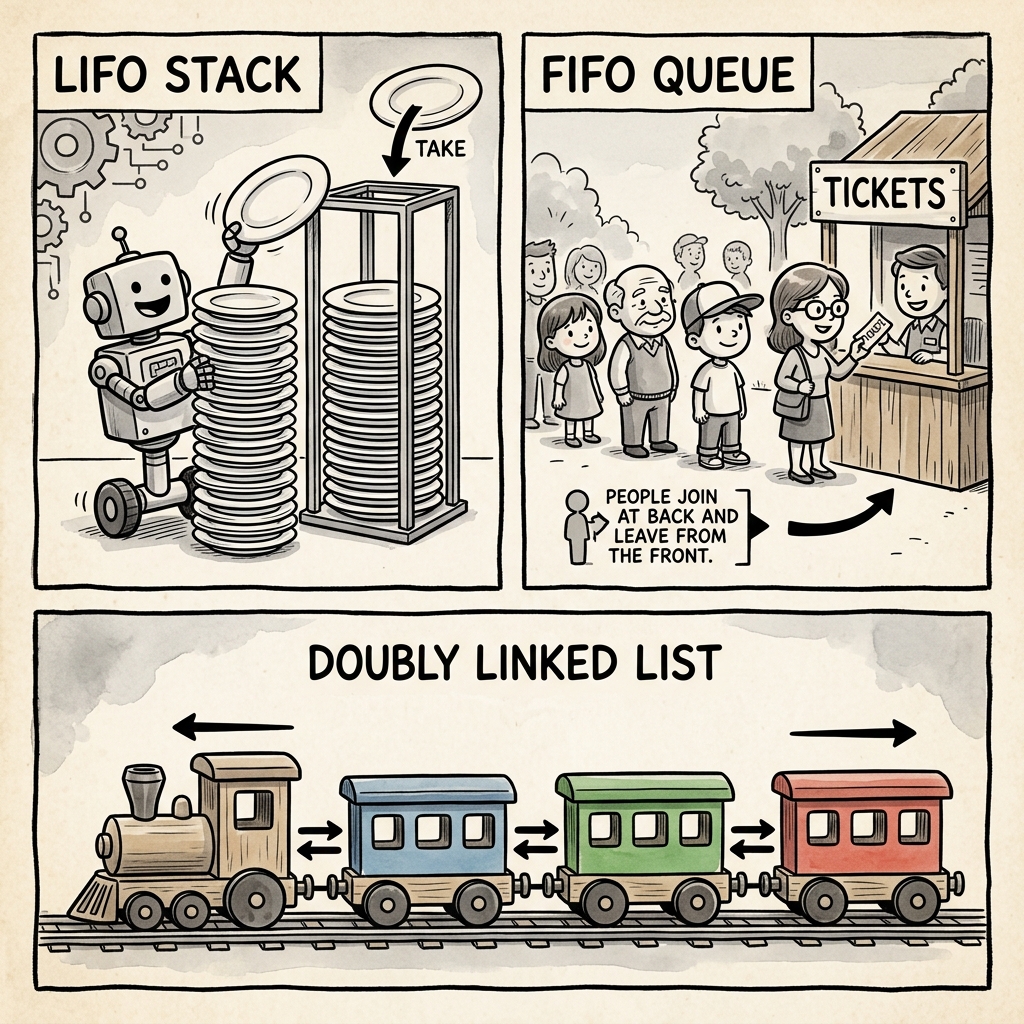
Sezione intitolata “2. La Pila (Stack)”La Pila (o Stack) è una struttura dati lineare governata dalla logica LIFO (Last-In, First-Out): l’ultimo elemento inserito è sempre il primo ad essere rimosso.
2.1 Metafore e Casi d’Uso
Sezione intitolata “2.1 Metafore e Casi d’Uso”- Metafora reale: Una pila di piatti in un dispenser a molla: possiamo appoggiare un piatto solo sopra la cima, e possiamo prelevare solo l’ultimo piatto posato in cima.
- Applicazioni informatiche:
- Lo Stack dei Record di Attivazione delle funzioni gestito a livello hardware della CPU.
- La funzionalità “Annulla” (Undo o Ctrl+Z) dei programmi di videoscrittura.
- La cronologia di navigazione dei browser web (il tasto “Indietro” torna all’ultima pagina visitata).
2.2 Implementazione di una Pila in C
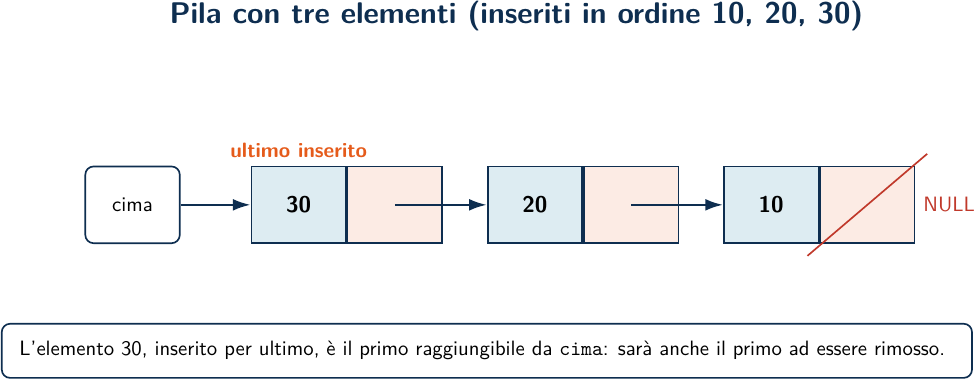
Sezione intitolata “2.2 Implementazione di una Pila in C”Per implementare una pila dinamica senza sprechi di memoria, utilizziamo una lista concatenata semplice. Facciamo coincidere la “cima” della pila con la testa della lista. In questo modo, sia l’inserimento (push) che la rimozione (pop) avvengono in testa alla lista in tempo costante , evitando di scorrere i nodi.
#include <stdio.h>#include <stdlib.h>#include <stdbool.h>
// Definizione del nodotypedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
// Definizione del tipo astratto Pilatypedef Nodo* Pila;
// Inizializza una pila vuotaPila crea_pila(void) {    return NULL;}
// Verifica se la pila è vuotabool is_empty_pila(Pila p) {    return p == NULL;}
Operazioni Push, Pop e Peek
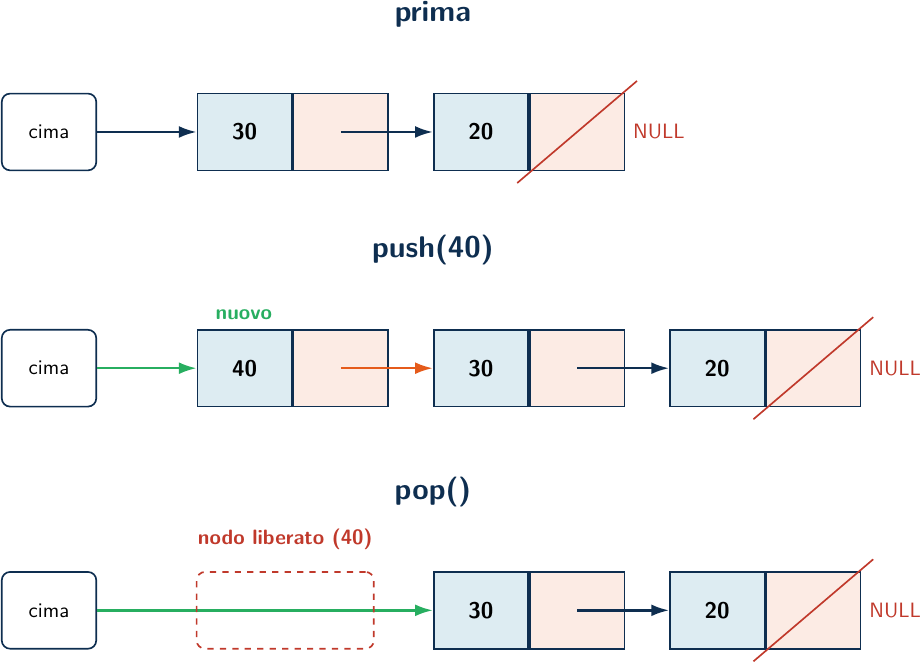
Sezione intitolata “Operazioni Push, Pop e Peek”Le operazioni di push e pop permettono di inserire ed eliminare elementi dalla pila, come mostrato di seguito:
L’operazione peek permette di leggere l’elemento in cima alla pila senza eliminarlo dalla struttura.
Operazione Push
Sezione intitolata “Operazione Push”Inserisce un elemento in cima alla pila (equivalente a un inserimento in testa alla lista).
Pila push(Pila p, int valore) { Nodo *nuovo = (Nodo*) malloc(sizeof(Nodo)); if (nuovo == NULL) { fprintf(stderr, "Errore: Memoria esaurita\n"); exit(1); } nuovo->dato = valore; nuovo->prossimo = p; // Il nuovo nodo punta alla vecchia cima return nuovo; // Il nuovo nodo diventa la nuova cima della pila}Operazione Pop
Sezione intitolata “Operazione Pop”Estrae l’elemento in cima alla pila, ne restituisce il valore attraverso un puntatore e dealloca il nodo rimosso.
bool pop(Pila *p, int *valore_estratto) {    if (is_empty_pila(*p)) {        return false; // Underflow della pila (pila vuota)    }
    Nodo *da_eliminare = *p;    *valore_estratto = da_eliminare->dato;
    *p = (*p)->prossimo; // Sposta la cima sul nodo successivo    free(da_eliminare);  // Dealloca la memoria    return true;}
Operazione Peek
Sezione intitolata “Operazione Peek”Consente di ispezionare il valore in cima alla pila senza rimuoverlo.
bool peek(Pila p, int *valore_cima) { if (is_empty_pila(p)) { return false; } *valore_cima = p->dato; return true;}3. La Coda (Queue)
Sezione intitolata “3. La Coda (Queue)”La Coda (o Queue) è una struttura dati lineare governata dalla logica FIFO (First-In, First-Out): il primo elemento inserito è il primo ad essere rimosso.
3.1 Metafore e Casi d’Uso
Sezione intitolata “3.1 Metafore e Casi d’Uso”- Metafora reale: La fila ordinata alle casse di un supermercato: chi arriva per primo viene servito per primo, chi si accoda per ultimo deve attendere il proprio turno.
- Applicazioni informatiche:
- La coda di stampa del sistema operativo.
- La trasmissione dei pacchetti di dati nei buffer di memoria dei router di rete.
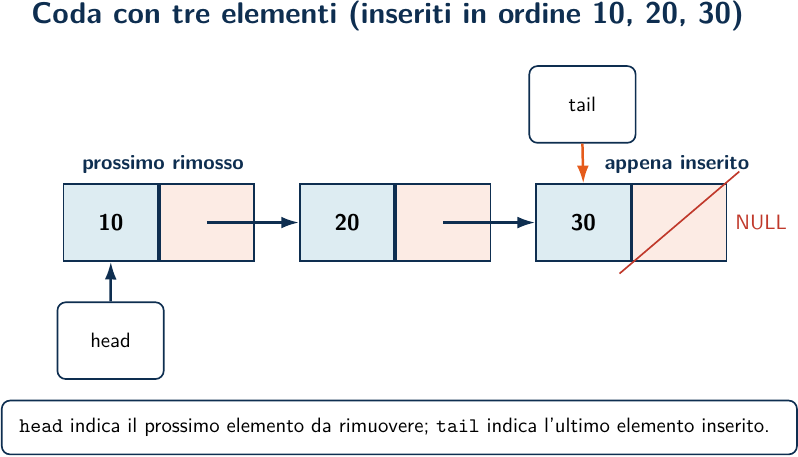
3.2 Testa, Coda ed Efficienza
Sezione intitolata “3.2 Testa, Coda ed Efficienza”Se implementiamo una coda usando una normale lista semplice memorizzando solo il puntatore di testa:
- Se estraiamo (
dequeue) in testa alla lista, l’operazione richiede tempo costante . - Se inseriamo (
enqueue) in coda alla lista, siamo costretti a scorrere l’intera lista fino all’ultimo elemento ad ogni inserimento, con complessità temporale lineare .
Per ovviare a questo problema ed eseguire entrambe le operazioni in tempo costante , ingegnerizziamo una struttura di controllo che mantiene due puntatori:
- Un puntatore
headalla testa della lista (per prelevare). - Un puntatore
tailall’ultimo nodo della lista (per inserire).
3.3 Implementazione di una Coda in C
Sezione intitolata “3.3 Implementazione di una Coda in C”typedef struct NodoCoda { int dato; struct NodoCoda *prossimo;} NodoCoda;
// Struttura di controllo con doppio puntatoretypedef struct { NodoCoda *head; // Accesso all'inizio della coda (per dequeue) NodoCoda *tail; // Accesso alla fine della coda (per enqueue)} Coda;
// Inizializza la codavoid inizializza_coda(Coda *c) { c->head = NULL; c->tail = NULL;}
// Verifica se la coda è vuotabool is_empty_coda(const Coda *c) { return c->head == NULL;}Operazioni di Enqueue e Dequeue
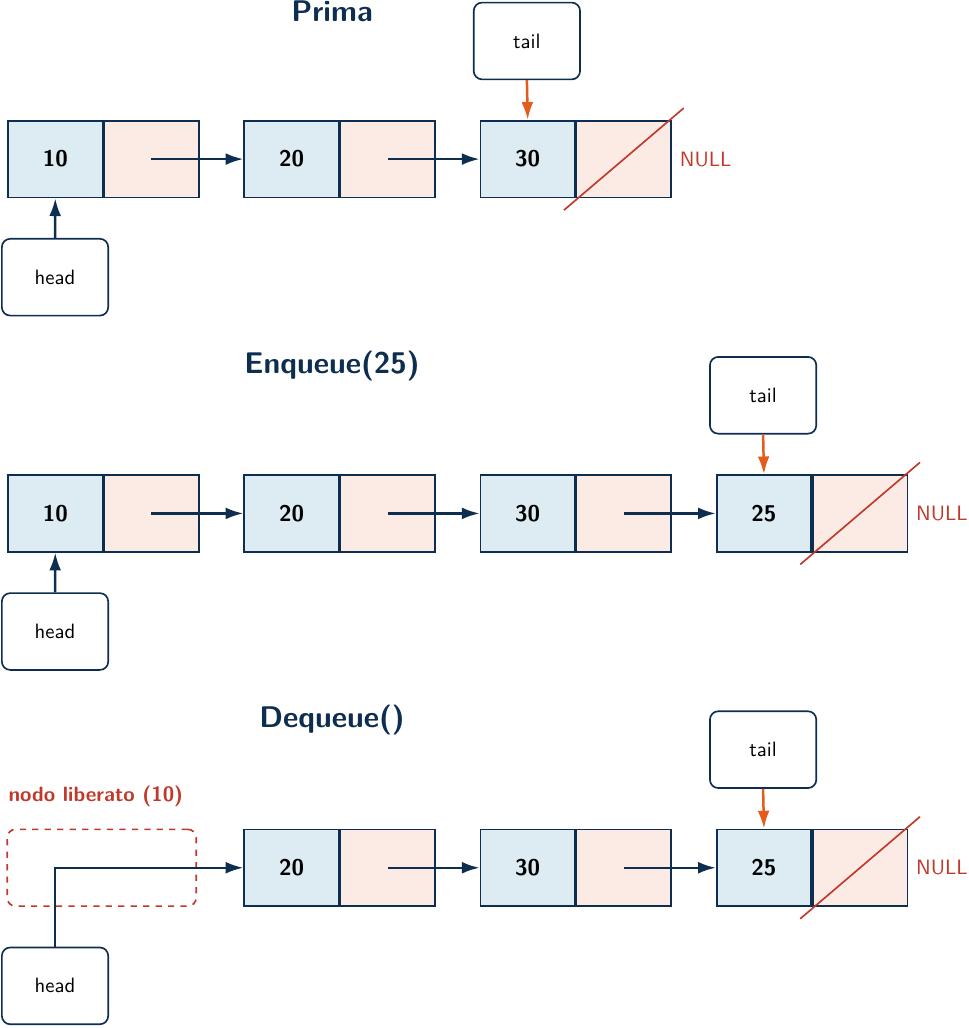
Sezione intitolata “Operazioni di Enqueue e Dequeue”Le operazioni di enqueue e dequeue permettono di inserire e rimuovere elmenti dalla coda, come mostrato di seguito:
Operazione Enqueue
Sezione intitolata “Operazione Enqueue”Aggiunge un elemento alla fine della coda in tempo sfruttando il puntatore tail.
void enqueue(Coda *c, int valore) {    NodoCoda *nuovo = (NodoCoda*) malloc(sizeof(NodoCoda));    if (nuovo == NULL) {        fprintf(stderr, "Errore: Memoria esaurita\n");        exit(1);    }    nuovo->dato = valore;    nuovo->prossimo = NULL;
    if (is_empty_coda(c)) {        // Se la coda è vuota, il nuovo nodo è sia testa che coda        c->head = nuovo;        c->tail = nuovo;    } else {        // Il vecchio ultimo nodo viene collegato al nuovo        c->tail->prossimo = nuovo;        // Il puntatore di coda si sposta sul nuovo nodo        c->tail = nuovo;    }}
Operazione Dequeue
Sezione intitolata “Operazione Dequeue”Estrae l’elemento in testa alla coda in tempo sfruttando il puntatore head.
bool dequeue(Coda *c, int *valore_estratto) {    if (is_empty_coda(c)) {        return false; // Underflow della coda    }
    NodoCoda *da_eliminare = c->head;    *valore_estratto = da_eliminare->dato;
    c->head = c->head->prossimo; // La testa avanza al nodo successivo
    // Se la coda si è svuotata, azzeriamo anche il puntatore tail    if (c->head == NULL) {        c->tail = NULL;    }
    free(da_eliminare); // Deallocazione memoria    return true;}
4. Liste Doppiamente Concatenate
Sezione intitolata “4. Liste Doppiamente Concatenate”Nelle liste semplici, ogni nodo contiene solo un puntatore in avanti (prossimo). Questo rende impossibile retrocedere o effettuare scansioni all’indietro.
4.1 La Struttura dei Nodi Doppi
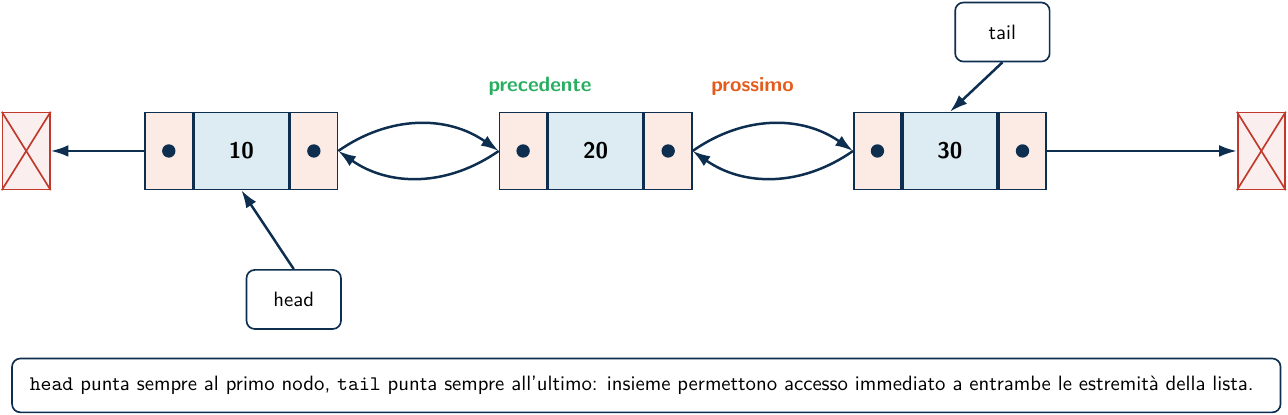
Sezione intitolata “4.1 La Struttura dei Nodi Doppi”Per navigare in entrambe le direzioni, ogni nodo ospita due puntatori:
- Un puntatore
prossimoche punta in avanti. - Un puntatore
precedenteche punta all’indietro.
typedef struct NodoDoppio {    int dato;    struct NodoDoppio *precedente; // Collegamento all'indietro    struct NodoDoppio *prossimo;   // Collegamento in avanti} NodoDoppio;
// Struttura di controllo per la gestione ottimizzatatypedef struct {    NodoDoppio *head; // Inizio lista    NodoDoppio *tail; // Fine lista} ListaDoppia;
// Inizializzazione della lista doppiavoid inizializza_lista_doppia(ListaDoppia *l) { l->head = NULL; l->tail = NULL;}
// Allocazione del singolo nodo doppioNodoDoppio* crea_nodo_doppio(int valore) { NodoDoppio *nuovo = (NodoDoppio*) malloc(sizeof(NodoDoppio)); if (nuovo == NULL) { fprintf(stderr, "Errore: RAM esaurita!\n"); exit(1); } nuovo->dato = valore; nuovo->precedente = NULL; nuovo->prossimo = NULL; return nuovo;}4.2 Inserimenti Bilaterali
Sezione intitolata “4.2 Inserimenti Bilaterali”Grazie alla presenza del puntatore tail e del collegamento precedente, possiamo inserire elementi sia in testa che in coda alla lista in tempo costante senza mai dover effettuare scansioni lineari dei nodi.
Inserimento in Testa
Sezione intitolata “Inserimento in Testa”void inserisci_testa_doppia(ListaDoppia *l, int valore) { NodoDoppio *nuovo = crea_nodo_doppio(valore);
if (l->head == NULL) { // Caso lista vuota: il nuovo nodo è sia testa che coda l->head = nuovo; l->tail = nuovo; } else { nuovo->prossimo = l->head; // Il nuovo punta in avanti alla vecchia testa l->head->precedente = nuovo; // La vecchia testa punta all'indietro al nuovo l->head = nuovo; // Aggiorniamo la testa di controllo }}Inserimento in Coda
Sezione intitolata “Inserimento in Coda”void inserisci_coda_doppia(ListaDoppia *l, int valore) { NodoDoppio *nuovo = crea_nodo_doppio(valore);
if (l->head == NULL) { // Caso lista vuota l->head = nuovo; l->tail = nuovo; } else { nuovo->precedente = l->tail; // Il nuovo si allaccia all'indietro al vecchio ultimo l->tail->prossimo = nuovo; // Il vecchio ultimo punta in avanti al nuovo arrivato l->tail = nuovo; // Aggiorniamo la coda di controllo }}4.3 Rimozione Istantanea
Sezione intitolata “4.3 Rimozione Istantanea”Il grande vantaggio delle liste doppie risiede nell’eliminazione di un nodo. Se si possiede già il puntatore esatto al nodo da eliminare (da_eliminare), non occorre alcuna scansione della lista per trovare il predecessore. L’operazione avviene in tempo costante ricollegando direttamente i puntatori dei nodi adiacenti.
void rimuovi_nodo_doppio(ListaDoppia *l, NodoDoppio *da_eliminare) {    if (l->head == NULL || da_eliminare == NULL) return;
    // Se il nodo da eliminare è la testa    if (l->head == da_eliminare) {        l->head = da_eliminare->prossimo;    }
    // Se il nodo da eliminare è la coda    if (l->tail == da_eliminare) {        l->tail = da_eliminare->precedente;    }
    // Ricuciamo il nodo precedente    if (da_eliminare->precedente != NULL) {        da_eliminare->precedente->prossimo = da_eliminare->prossimo;    }
    // Ricuciamo il nodo successivo    if (da_eliminare->prossimo != NULL) {        da_eliminare->prossimo->precedente = da_eliminare->precedente;    }
    free(da_eliminare);}
4.4 I Trade-off Ingegneristici
Sezione intitolata “4.4 I Trade-off Ingegneristici”- Consumo di memoria: Ogni nodo deve memorizzare due puntatori (8 byte ciascuno su sistemi a 64 bit), aumentando l’overhead strutturale.
- Complessità del codice: Ogni inserimento o cancellazione richiede l’aggiornamento simultaneo di un massimo di 4 puntatori, aumentando il rischio di bug e puntatori orfani in RAM.
5. Quiz di Autovalutazione
Sezione intitolata “5. Quiz di Autovalutazione”1. Che cos’è un Tipo di Dato Astratto (ADT)?
- A) Una struttura dati non ancora implementata dal compilatore.
- B) Un modello logico definito dalle operazioni consentite e dalle regole d’accesso, indipendente dall’implementazione fisica.
- C) Un tipo di puntatore generico
void*che può indirizzare qualsiasi area dello Heap. - D) Una macro definita con
#defineper memorizzare variabili intere.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Gli ADT definiscono il comportamento logico (l’interfaccia pubblica), nascondendo i dettagli implementativi fisici (l’incapsulamento sotto il cofano).
2. Quale logica regola l’accesso agli elementi in una Pila (Stack)?
- A) FIFO (First-In, First-Out)
- B) LIFO (Last-In, First-Out)
- C) LILO (Last-In, Last-Out)
- D) Accesso casuale tramite indice numerico
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: In uno Stack, l’ultimo elemento inserito (cima) è il primo a essere rimosso, proprio come in una pila fisica di piatti.
3. Nell’implementazione di una Pila tramite lista concatenata semplice, perché facciamo coincidere la cima con la testa della lista?
- A) Per risparmiare memoria escludendo il puntatore
NULL. - B) Per effettuare l’inserimento (
push) e la rimozione (pop) in tempo costante senza scorrere la lista. - C) Perché la testa della lista risiede nello Stack frame invece che nello Heap.
- D) Per ordinare automaticamente gli elementi inseriti.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Operare in testa a una lista semplice richiede solo la modifica locale dei puntatori senza dover scorrere i nodi intermedi.
4. Cosa si intende per “Underflow” di una Pila?
- A) L’esaurimento della memoria fisica Heap a seguito di una
mallocfallita. - B) Il tentativo di rimuovere un elemento (
pop) da una pila che è attualmente vuota. - C) La perdita del puntatore alla testa della lista.
- D) L’accumulo di record di attivazione causato da ricorsione infinita.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: L’underflow si verifica quando un’operazione di rimozione fallisce perché la struttura dati è priva di elementi.
5. Quale logica regola l’accesso agli elementi in una Coda (Queue)?
- A) FIFO (First-In, First-Out)
- B) LIFO (Last-In, First-Out)
- C) Accesso casuale indicizzato
- D) Ordinamento alfabetico automatico
▶ Mostra Risposta Corretta
Risposta corretta: A
Spiegazione: In una Coda, il primo elemento inserito è il primo a uscire, rispecchiando il comportamento di una fila ordinata di persone.
6. Perché una semplice lista concatenata con il solo puntatore head non è efficiente per implementare una Coda?
- A) Perché l’estrazione richiede di scorrere tutti gli elementi.
- B) Perché l’inserimento in coda alla lista richiede uno scorrimento lineare di tutti i nodi.
- C) Perché non permette la memorizzazione di dati di tipo intero.
- D) Perché causa costanti errori di segmentation fault a runtime.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Senza un riferimento diretto all’ultimo nodo, per inserire in coda occorre scorrere l’intera lista partendo dalla testa, un’operazione costosa all’aumentare dei nodi.
7. In una Coda ottimizzata con puntatori head e tail, qual è la complessità dell’operazione di accodamento (enqueue)?
- A) Tempo lineare
- B) Tempo costante
- C) Tempo logaritmico
- D) Tempo quadratico
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Sfruttando il puntatore tail che referenzia direttamente l’ultimo nodo, l’aggancio del nuovo elemento avviene all’istante senza dover effettuare alcuna scansione.
8. Che cos’è una Lista Doppiamente Concatenata?
- A) Una lista che può contenere solo coppie di valori uguali.
- B) Una lista formata da nodi contenenti due puntatori, uno al nodo successivo e uno al nodo precedente.
- C) Una lista memorizzata contemporaneamente in due settori diversi della RAM.
- D) Una lista che supporta due puntatori di testa separati.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: La bidirezionalità è consentita dalla presenza del puntatore precedente in ogni nodo, permettendo la scansione a ritroso.
9. Nelle liste doppie, qual è la complessità temporale per eliminare un nodo se possediamo già il suo puntatore esatto?
- A) Tempo lineare
- B) Tempo costante
- C) Tempo quadratico
- D) L’operazione non è permessa a runtime
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Poiché il nodo contiene già gli indirizzi sia del successore che del predecessore, non serve effettuare alcuna scansione della lista per ricucire i collegamenti.
10. Qual è il principale svantaggio delle liste doppie rispetto alle liste semplici?
- A) L’impossibilità di allocarle nello Heap.
- B) Un consumo di memoria maggiore per ogni nodo e una maggiore complessità nella gestione del codice (chirurgia dei puntatori).
- C) La mancanza di supporto per l’allocazione dinamica tramite
malloc. - D) La limitazione a contenere unicamente payload di tipo float.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: I due puntatori per nodo raddoppiano lo spazio di RAM dedicato ai collegamenti, e le operazioni sui puntatori richiedono molta attenzione per non perdere i legami bilaterali.
6. Esercizi Pratici Risolti
Sezione intitolata “6. Esercizi Pratici Risolti”Esercizio 1: Controllo Pila Vuota
Sezione intitolata “Esercizio 1: Controllo Pila Vuota”Scrivere una funzione in C che verifichi se una pila è vuota.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdbool.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
typedef Nodo* Pila;
bool is_empty_pila(Pila p) {    // La pila è vuota se il puntatore di testa è NULL    return (p == NULL);}
Esercizio 2: Conteggio Nodi in Pila
Sezione intitolata “Esercizio 2: Conteggio Nodi in Pila”Scrivere una funzione che conti gli elementi all’interno di una pila senza distruggerla (senza svuotarla).
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
typedef Nodo* Pila;
int conta_elementi_pila(Pila p) {    int contatore = 0;    Nodo *corrente = p; // Usiamo un puntatore temporaneo per non modificare la testa originale    while (corrente != NULL) {        contatore++;        corrente = corrente->prossimo;    }    return contatore;}
Esercizio 3: Ispezione in Cima (Peek)
Sezione intitolata “Esercizio 3: Ispezione in Cima (Peek)”Scrivere una funzione peek che legga il valore in cima alla pila restituendo true se l’operazione ha successo, e false se la pila è vuota.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdbool.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
typedef Nodo* Pila;
bool peek(Pila p, int *valore) {    if (p == NULL) {        return false; // Pila vuota    }    *valore = p->dato; // Assegna il valore in cima    return true;}
Esercizio 4: Inizializzazione Coda
Sezione intitolata “Esercizio 4: Inizializzazione Coda”Implementare la struttura dati di controllo e la funzione per inizializzare una coda dinamica a vuota.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct NodoCoda {    int dato;    struct NodoCoda *prossimo;} NodoCoda;
typedef struct {    NodoCoda *head;    NodoCoda *tail;} Coda;
void inizializza_coda(Coda *c) {    c->head = NULL;    c->tail = NULL;}
Esercizio 5: Stampa Coda
Sezione intitolata “Esercizio 5: Stampa Coda”Scrivere una funzione che stampi a schermo tutti gli elementi presenti in una coda, dall’inizio alla fine.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct NodoCoda {    int dato;    struct NodoCoda *prossimo;} NodoCoda;
typedef struct {    NodoCoda *head;    NodoCoda *tail;} Coda;
void stampa_coda(const Coda *c) {    NodoCoda *corrente = c->head;    printf("Inizio Coda -> ");    while (corrente != NULL) {        printf("[%d] -> ", corrente->dato);        corrente = corrente->prossimo;    }    printf("Fine Coda (NULL)\n");}
Esercizio 6: Dimensione Coda
Sezione intitolata “Esercizio 6: Dimensione Coda”Scrivere una funzione che determini la dimensione corrente (numero di elementi) di una coda.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct NodoCoda {    int dato;    struct NodoCoda *prossimo;} NodoCoda;
typedef struct {    NodoCoda *head;    NodoCoda *tail;} Coda;
int dimensione_coda(const Coda *c) {    int count = 0;    NodoCoda *corrente = c->head;    while (corrente != NULL) {        count++;        corrente = corrente->prossimo;    }    return count;}
Esercizio 7: Ricerca in Lista Doppia
Sezione intitolata “Esercizio 7: Ricerca in Lista Doppia”Scrivere una funzione che ricerchi un intero in una lista doppia e restituisca l’indirizzo del nodo se trovato, o NULL altrimenti.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
typedef struct NodoDoppio {    int dato;    struct NodoDoppio *precedente;    struct NodoDoppio *prossimo;} NodoDoppio;
typedef struct {    NodoDoppio *head;    NodoDoppio *tail;} ListaDoppia;
NodoDoppio* cerca_lista_doppia(const ListaDoppia *l, int target) {    NodoDoppio *corrente = l->head;    while (corrente != NULL) {        if (corrente->dato == target) {            return corrente; // Trovato        }        corrente = corrente->prossimo;    }    return NULL; // Non trovato}
Esercizio 8: Inserimento in Testa Lista Doppia
Sezione intitolata “Esercizio 8: Inserimento in Testa Lista Doppia”Scrivere la funzione per inserire un elemento in testa a una lista doppiamente concatenata.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct NodoDoppio {    int dato;    struct NodoDoppio *precedente;    struct NodoDoppio *prossimo;} NodoDoppio;
typedef struct {    NodoDoppio *head;    NodoDoppio *tail;} ListaDoppia;
void inserisci_testa_doppia(ListaDoppia *l, int valore) {    NodoDoppio *nuovo = (NodoDoppio*) malloc(sizeof(NodoDoppio));    if (nuovo == NULL) exit(1);
    nuovo->dato = valore;    nuovo->precedente = NULL;    nuovo->prossimo = l->head;
    if (l->head == NULL) {        // La lista era vuota        l->head = nuovo;        l->tail = nuovo;    } else {        l->head->precedente = nuovo;        l->head = nuovo;    }}
Esercizio 9: Inserimento in Coda Lista Doppia
Sezione intitolata “Esercizio 9: Inserimento in Coda Lista Doppia”Scrivere la funzione per inserire un elemento in coda a una lista doppiamente concatenata.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct NodoDoppio {    int dato;    struct NodoDoppio *precedente;    struct NodoDoppio *prossimo;} NodoDoppio;
typedef struct {    NodoDoppio *head;    NodoDoppio *tail;} ListaDoppia;
void inserisci_coda_doppia(ListaDoppia *l, int valore) {    NodoDoppio *nuovo = (NodoDoppio*) malloc(sizeof(NodoDoppio));    if (nuovo == NULL) exit(1);
    nuovo->dato = valore;    nuovo->prossimo = NULL;    nuovo->precedente = l->tail;
    if (l->tail == NULL) {        // La lista era vuota        l->head = nuovo;        l->tail = nuovo;    } else {        l->tail->prossimo = nuovo;        l->tail = nuovo;    }}
Esercizio 10: Svuota Pila (Deallocazione)
Sezione intitolata “Esercizio 10: Svuota Pila (Deallocazione)”Scrivere una funzione che svuoti completamente una pila deallocando tutti i nodi occupati nello Heap.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
typedef struct Nodo {    int dato;    struct Nodo *prossimo;} Nodo;
typedef Nodo* Pila;
void svuota_pila(Pila *p) {    Nodo *corrente = *p;    while (corrente != NULL) {        Nodo *successore = corrente->prossimo; // Salva il successivo        free(corrente);                       // Libera il nodo corrente        corrente = successore;                // Sposta corrente in avanti    }    *p = NULL; // Imposta la testa a NULL}