Lezione 12: Basso Livello, File Binari e l'Abisso della Ricorsione
Nelle lezioni precedenti abbiamo visto come salvare informazioni in file testuali leggibili. Tuttavia, la formattazione in testo ASCII introduce conversioni costose e rende difficile saltare direttamente a un dato specifico senza leggere sequenzialmente tutto ciò che lo precede.
In questa lezione esploreremo la vera forma dei dati in memoria fisica: impareremo a “fotocopiare” i byte dalla RAM al disco rigido creando File Binari tramite fwrite e fread, ad ispezionare il loro contenuto a basso livello svelando le convenzioni sull’ordinamento dei byte (Little Endian) e a navigare liberamente nello spazio assoluto del file tramite fseek e ftell. Nella seconda parte della lezione approfondiremo la struttura della Ricorsione, analizzandone l’eleganza algoritmica, l’impatto sul Record di Attivazione nello Stack, il rischio hardware di Stack Overflow e le tecniche di ottimizzazione tramite la ricorsione di coda (Tail Recursion).
1. I File Binari e l’Ispezione a Basso Livello
Sezione intitolata “1. I File Binari e l’Ispezione a Basso Livello”1.1 Testo contro Binario: L’Illusione ASCII
Sezione intitolata “1.1 Testo contro Binario: L’Illusione ASCII”Quando salviamo un numero intero come 1000000 (un milione) usando fprintf, la funzione converte il numero in una stringa di sette caratteri ASCII ("1", "0", "0", "0", "0", "0", "0"). Sul disco rigido, questo numero occuperà esattamente 7 byte (uno per carattere). Se scrivessimo il valore 1000000000 (un miliardo), esso occuperebbe 10 byte.
In memoria RAM, tuttavia, un tipo intero (int) occupa rigorosamente 4 byte (32 bit) di spazio a prescindere dal valore numerico immagazzinato. Il formato testuale costringe la CPU a compiere continui cicli di conversione in potenze di dieci per tradurre i bit interni in cifre leggibili.
Per ovviare a questo spreco di tempo di calcolo e spazio, possiamo memorizzare i dati su disco nella loro rappresentazione binaria nativa. Un file binario è una copia esatta byte per byte (un dump) di una determinata area di memoria RAM trasferita direttamente su disco senza alcuna traduzione o formattazione.
1.2 La Scrittura Binaria con fwrite
Sezione intitolata “1.2 La Scrittura Binaria con fwrite”Per aprire un file in modalità binaria si aggiunge il carattere b alla modalità di apertura in fopen (ad es. "wb" per la scrittura e "rb" per la lettura).
La funzione standard fwrite consente di riversare porzioni di memoria RAM sul file stream e accetta quattro argomenti:
- L’indirizzo di memoria di partenza da cui leggere i dati.
- La dimensione in byte di un singolo elemento (ad es.
sizeof(int)). - Il numero di elementi consecutivi da scrivere.
- Il puntatore allo stream del file (
FILE *).
Codice C: Confronto tra scrittura testuale e binaria
Sezione intitolata “Codice C: Confronto tra scrittura testuale e binaria”#include <stdio.h>
int main(void) { int numero = 1000000; // 1 milione
// 1. Scrittura Testuale (fprintf) FILE *fp_txt = fopen("numero.txt", "w"); if (fp_txt != NULL) { fprintf(fp_txt, "%d", numero); fclose(fp_txt); }
// 2. Scrittura Binaria (fwrite) FILE *fp_bin = fopen("numero.bin", "wb"); if (fp_bin != NULL) { fwrite(&numero, sizeof(int), 1, fp_bin); fclose(fp_bin); }
printf("File generati correttamente.\n"); return 0;}Verificando le proprietà fisiche dei file sul disco, si noterà che numero.txt ha una dimensione pari a 7 byte, mentre numero.bin occupa solo 4 byte, contenendo la rappresentazione binaria del numero.
1.3 Hexdump e la Rappresentazione Little Endian
Sezione intitolata “1.3 Hexdump e la Rappresentazione Little Endian”Se proviamo ad aprire il file numero.bin con un comune editor di testo, visualizzeremo caratteri incomprensibili (come @B). Questo accade perché l’editor tenta erroneamente di interpretare i byte numerici come caratteri ASCII stampabili.
Per ispezionare correttamente il contenuto a basso livello di un file binario, si utilizzano utility di terminale come hexdump:
$ hexdump -C numero.binL’output esadecimale mostrerà la seguente configurazione:
00000000 40 42 0f 00 |@B..|Matematicamente, il numero in base esadecimale corrisponde a 0x000F4240. Nel file binario, tuttavia, l’ordine dei byte risulta invertito (40 42 0F 00).
Questo fenomeno deriva dall’architettura dei processori moderni (in particolare la famiglia x86-64 di Intel e AMD), la quale adotta la convenzione Little Endian: i byte che costituiscono una parola multi-byte vengono memorizzati in RAM partendo dal byte meno significativo (a destra) fino a quello più significativo (a sinistra). La funzione fwrite si limita a copiare fedelmente l’esatta sequenza di byte presente in RAM sul disco rigido.
2. Accesso Casuale e Gestione dei Record Binari
Sezione intitolata “2. Accesso Casuale e Gestione dei Record Binari”2.1 Salvataggio di Array in Blocco
Sezione intitolata “2.1 Salvataggio di Array in Blocco”Poiché in C gli elementi di un array sono memorizzati in posizioni di memoria contigue, è possibile scrivere l’intero array su disco con un’unica invocazione di fwrite, evitando i cicli iterativi:
int dati[5] = {10, 20, 30, 40, 50};// Copia diretta di (5 * sizeof(int)) = 20 byte consecutivifwrite(dati, sizeof(int), 5, fp_bin);Specularmente, per leggere i dati salvati si utilizza fread su un file aperto in modalità "rb":
int letti[5];fread(letti, sizeof(int), 5, fp_bin);2.2 Navigazione nel File con fseek e ftell
Sezione intitolata “2.2 Navigazione nel File con fseek e ftell”La lettura sequenziale ci costringe a leggere il file dall’inizio alla fine (ad esempio, per leggere il centesimo record di un file di testo, siamo costretti a leggere a vuoto le prime 99 righe).
Nei file binari, grazie alla dimensione costante e nota dei dati, possiamo posizionare il puntatore di lettura in qualsiasi punto dello stream istantaneamente tramite la funzione fseek:
int fseek(FILE *stream, long offset, int origin);Il parametro origin può assumere tre costanti standard:
SEEK_SET: Spostamento relativo all’inizio del file (offset positivo).SEEK_CUR: Spostamento relativo alla posizione corrente del cursore.SEEK_END: Spostamento relativo alla fine del file (generalmente con offset negativo).
Per conoscere in quale byte esatto del file si trova attualmente il cursore di lettura, si utilizza la funzione ftell:
long posizione = ftell(fp);Codice C: Lettura diretta di un elemento specifico
Sezione intitolata “Codice C: Lettura diretta di un elemento specifico”FILE *fp = fopen("array.bin", "rb");if (fp != NULL) { // Saltiamo i primi due interi (2 * 4 = 8 byte) a partire dall'inizio del file fseek(fp, 2 * sizeof(int), SEEK_SET);
int terzo_numero; fread(&terzo_numero, sizeof(int), 1, fp); printf("Terzo elemento dell'array letto direttamente: %d\n", terzo_numero); // Stampa 30 fclose(fp);}2.3 Record a Dimensione Fissa e Stringhe Variabili
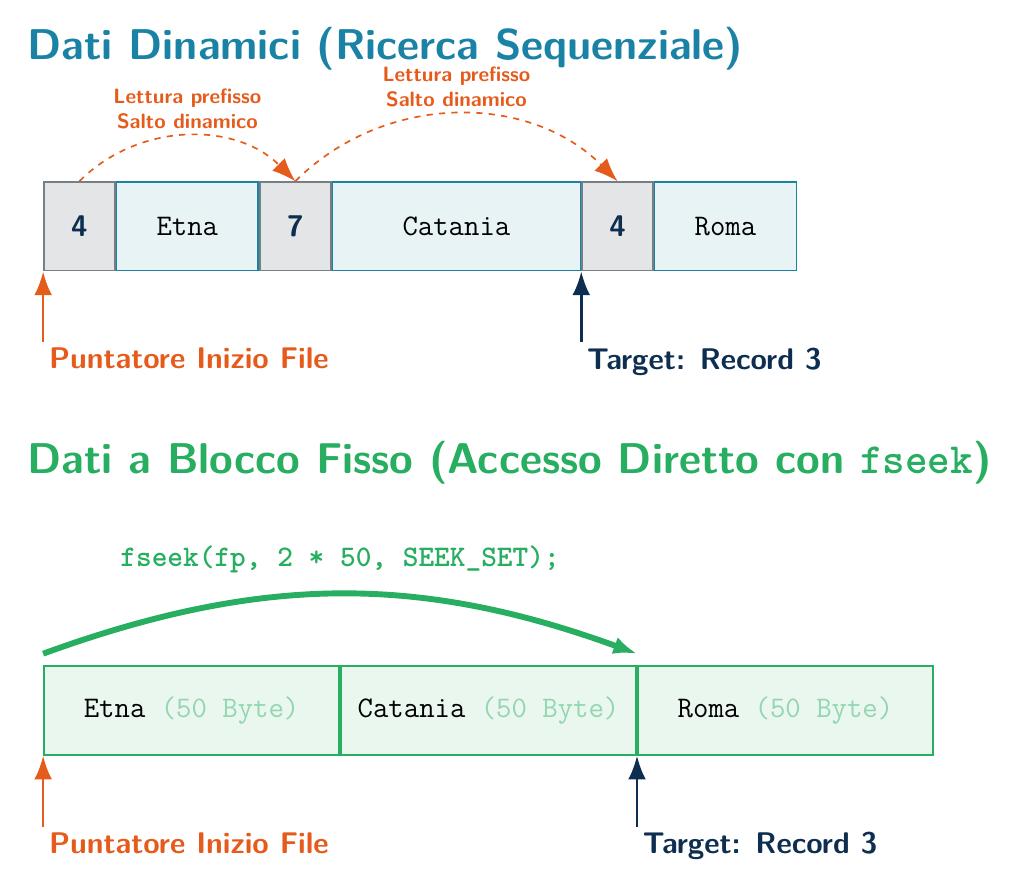
Sezione intitolata “2.3 Record a Dimensione Fissa e Stringhe Variabili”Se decidiamo di salvare record di testo a lunghezza variabile preceduti dalla loro dimensione (ad esempio memorizzando prima un intero con la lunghezza e poi i caratteri), perdiamo la possibilità di utilizzare fseek ad offset costante:
| Record 1 | 4 | ”Etna” | Record 2 | 7 | ”Catania” | Record 3 | 4 | ”Roma” |
|---|
Per raggiungere il terzo record, non conoscendo a priori la lunghezza dei primi due, saremmo costretti a una scansione sequenziale passiva dei prefissi.
Per poter sfruttare l’efficienza dell’accesso diretto, è necessario adottare record a dimensione fissa (ad esempio riservando sempre 50 byte per il campo nome: char nome[50]). Imponendo dimensioni costanti a ciascun blocco di dati, la posizione iniziale del record d’indice sarà calcolabile matematicamente con la formula:
3. L’Abisso della Ricorsione e i Limiti dello Stack
Sezione intitolata “3. L’Abisso della Ricorsione e i Limiti dello Stack”3.1 I Principi della Ricorsione
Sezione intitolata “3.1 I Principi della Ricorsione”La ricorsione è un metodo di programmazione in cui una funzione risolve un problema richiamando se stessa su sotto-problemi più piccoli dello stesso tipo.
Per prevenire l’esecuzione indefinita delle chiamate, ogni funzione ricorsiva deve implementare due parti essenziali:
- Il Caso Base (o condizione di arresto): La situazione più semplice del problema la cui soluzione è banale e immediata. Rappresenta l’ancora di salvataggio del programma.
- Il Passo Ricorsivo: La chiamata ricorsiva alla funzione stessa. Per garantire che l’esecuzione termini, i parametri passati alla chiamata successiva devono convergere progressivamente verso il caso base.
3.2 Esempi Algoritmici Classici
Sezione intitolata “3.2 Esempi Algoritmici Classici”Il Calcolo del Fattoriale ()
Sezione intitolata “Il Calcolo del Fattoriale (N!N!N!)”- Caso Base: Il fattoriale di o di vale .
- Passo Ricorsivo: Il fattoriale di è pari a .
long long fattoriale(int n) { // Caso Base if (n == 0 || n == 1) { return 1; } // Passo Ricorsivo return n * fattoriale(n - 1);}Stampa Inversa di una Stringa
Sezione intitolata “Stampa Inversa di una Stringa”Sfruttando la memoria dello Stack, possiamo stampare a schermo una stringa al contrario senza dover manipolare gli indici in modo iterativo:
void stampa_inverso(char *str) {    // Caso Base: Carattere terminatore raggiunto    if (*str == '\0') {        return;    }    // Passo Ricorsivo: Avvia la chiamata per i caratteri successivi    stampa_inverso(str + 1);
    // Al ritorno dallo srotolamento delle funzioni, stampa il carattere corrente    putchar(*str);}
La Sequenza di Fibonacci
Sezione intitolata “La Sequenza di Fibonacci”La definizione ricorsiva della sequenza di Fibonacci prevede:
- Casi Base: Se ritorna ; se ritorna .
- Passo Ricorsivo: Ritorna la somma dei due numeri precedenti: .
int fibonacci(int n) {    // Casi Base    if (n == 0) return 0;    if (n == 1) return 1;
    // Passo Ricorsivo (Doppia chiamata)    return fibonacci(n - 1) + fibonacci(n - 2);}
3.3 Lo Stack Frame e la Catastrofe dello Stack Overflow
Sezione intitolata “3.3 Lo Stack Frame e la Catastrofe dello Stack Overflow”Ogni volta che viene invocata una funzione, il sistema operativo riserva una porzione di memoria RAM in cima all’area dello Stack, denominata Record di Attivazione (Stack Frame). Questo record contiene:
- Le variabili locali e i parametri della funzione.
- L’indirizzo di ritorno (l’istruzione del codice a cui tornare quando la funzione termina).
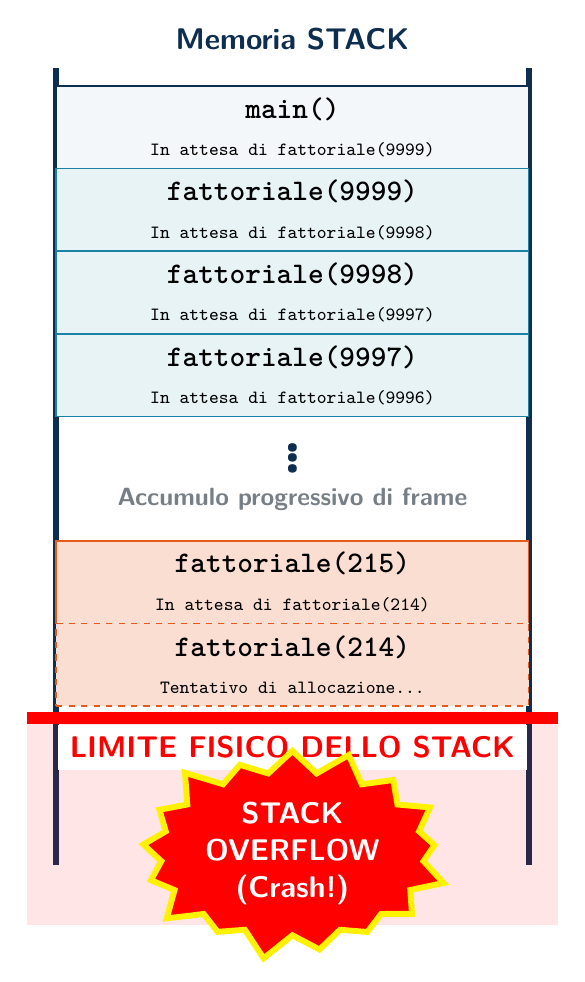
Nelle funzioni ricorsive, i vari Stack Frame si accumulano uno sopra l’altro nello Stack, rimanendo “sospesi” in attesa che l’ultima chiamata termini raggiungendo il caso base.
Se commettiamo un errore di logica escludendo il caso base, o se impostiamo una ricorsione estremamente profonda, lo Stack (la cui dimensione tipica allocata per il processo è di circa 8 MB) esaurisce il suo spazio fisico. Questo evento, denominato Stack Overflow, provoca la terminazione immediata del programma da parte del sistema operativo tramite un segnale di errore di segmentazione (Segmentation Fault).
3.4 Inefficienza e la Ricorsione di Coda (Tail Recursion)
Sezione intitolata “3.4 Inefficienza e la Ricorsione di Coda (Tail Recursion)”Prendiamo in esame l’implementazione classica e intuitiva della Sequenza di Fibonacci:
int fibonacci(int n) { if (n == 0) return 0; if (n == 1) return 1; return fibonacci(n - 1) + fibonacci(n - 2);}L’esecuzione di fibonacci(45) provocherà un visibile blocco della CPU. Questo accade perché lo sdoppiamento della chiamata ricorsiva crea un albero delle chiamate che cresce in modo esponenziale (), costringendo il processore a calcolare ripetutamente lo stesso sotto-problema migliaia di volte su rami differenti dell’albero.
La Ricorsione di Coda (Tail Recursion)
Sezione intitolata “La Ricorsione di Coda (Tail Recursion)”Una funzione ricorsiva si dice ricorsiva di coda (o tail recursive) se la chiamata ricorsiva rappresenta l’ultimissima istruzione eseguita, non lasciando alcuna computazione in sospeso al ritorno del controllo.
Nei compilatori moderni, l’abilitazione delle ottimizzazioni (ad es. gcc -O3) attiva la Tail Call Optimization (TCO). Il compilatore rileva la ricorsione di coda e riutilizza lo stesso Stack Frame per tutta la catena di chiamate, azzerando l’overhead spaziale sullo Stack e riducendolo a .
Possiamo ottimizzare la funzione di Fibonacci introducendo variabili accumulatrici per renderla tail-recursive, riducendo la complessità a temporale:
// Funzione ausiliaria ottimizzata per la ricorsione di codalong long fib_tail(int n, long long a, long long b) {    if (n == 0) return a;    if (n == 1) return b;    return fib_tail(n - 1, b, a + b); // Nessuna operazione rimasta dopo la chiamata}
long long fibonacci_efficiente(int n) {    return fib_tail(n, 0, 1);}
In C, sebbene il compilatore cerchi di ottimizzare le chiamate ricorsive di coda, la ricorsione espone a rischi strutturali legati ai limiti fisici dello Stack. Per elaborazioni sequenziali lineari (come Fibonacci o Fattoriale), l’uso dei classici cicli iterativi (for, while) rimane la scelta ottimale, garantendo un’occupazione di memoria costante ed eliminando alla radice il rischio di Stack Overflow.
📝 Quiz di Auto-valutazione
Sezione intitolata “📝 Quiz di Auto-valutazione”1. Quale delle seguenti affermazioni esprime la differenza fondamentale tra scrittura con fprintf e fwrite?
- A)
fprintfscrive in formato binario, mentrefwritescrive in ASCII. - B)
fprintftraduce i dati in stringhe ASCII leggibili, mentrefwriteesegue una copia grezza byte per byte della memoria RAM. - C)
fwriteinserisce automaticamente caratteri di nuova riga\nalla fine di ogni dato. - D)
fwritepuò operare solo su variabili di tipochar.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: fprintf effettua una conversione formattata traducendo i valori numerici in caratteri leggibili (testo), consumando tempo di calcolo e spazio variabile a seconda del numero. fwrite riversa direttamente i byte così come appaiono nella RAM fisica, in modo estremamente efficiente e a dimensione fissa.
2. Ispezionando un file binario contenente l’intero 1 su architettura Intel x86-64, l’hexdump mostra la sequenza di byte 01 00 00 00. Perché?
- A) Si tratta di un errore di compilazione.
- B) L’architettura adotta la convenzione Big Endian, memorizzando prima il byte più significativo.
- C) L’architettura adotta la convenzione Little Endian, memorizzando prima il byte meno significativo.
- D) Il file inserisce byte di controllo casuali per allineare la memoria.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Le architetture x86-64 sono di tipo Little Endian. In un intero a 4 byte (32 bit) avente valore 1 (0x00000001), il byte meno significativo (01) viene salvato all’indirizzo di memoria più basso, e quindi appare per primo nel dump sequenziale del file.
3. Cosa restituisce la chiamata fwrite(array, sizeof(double), 10, fp) in caso di scrittura completata con successo?
- A) Il valore intero 0.
- B) Il numero totale di byte scritti (ovvero 80).
- C) Il numero di elementi scritti con successo (ovvero 10).
- D) Il puntatore al file modificato.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Sia fwrite che fread restituiscono il numero di blocchi/elementi scritti o letti correttamente (il terzo parametro passato alla funzione), e non il numero totale di byte.
4. Quale parametro della funzione fseek indica lo spostamento a partire dalla fine del file?
- A)
SEEK_SET - B)
SEEK_CUR - C)
SEEK_END - D)
SEEK_EOF
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: SEEK_END indica al cursore di spostarsi a partire dalla fine del file (generalmente usando offset negativi per risalire il file all’indietro).
5. Cosa accade se si tenta di eseguire un fseek con un offset calcolato in modo fisso su un file binario con stringhe a lunghezza variabile senza prefisso fisso?
- A) Il programma crasha immediatamente.
- B) Si rischia di posizionare il cursore a metà di un dato, leggendo byte spuri che corrompono le variabili.
- C)
fseekcorregge automaticamente la posizione allineandosi all’inizio della parola. - D) Il file binario si converte automaticamente in file di testo.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Nei file binari non ci sono delimitatori naturali come gli spazi o i ritorni a capo. Se saltiamo ad un offset arbitrario non allineato con l’inizio di una variabile, i byte estratti verranno interpretati in modo completamente errato.
6. Cos’è uno Stack Frame (o Record di Attivazione)?
- A) Un blocco di memoria Heap usato per le stringhe globali.
- B) Una porzione di memoria dello Stack allocata ad ogni chiamata di funzione per conservare variabili locali, parametri e indirizzo di ritorno.
- C) Una modalità di compilazione sicura.
- D) Un descrittore per la navigazione dei file binari.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: Lo Stack Frame contiene tutte le informazioni contestuali a una singola chiamata di funzione. Quando una funzione chiama se stessa ricorsivamente, un nuovo stack frame viene inserito in cima allo Stack, restando in attesa che la chiamata nidificata si risolva.
7. Quale grave malfunzionamento hardware/software si verifica se una funzione ricorsiva non raggiunge mai il caso base?
- A) Memory Leak irreversibile nello Heap.
- B) Stack Overflow, causato dall’esaurimento della memoria Stack destinata ai record di attivazione del processo.
- C) Divisione per zero spontanea a livello di ALU.
- D) Corruzione fisica del file binario sul disco rigido.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: L’accumulo infinito di record di attivazione senza alcun caso base che svuoti lo stack porta rapidamente al superamento del limite fisico dello Stack, provocando la terminazione forzata del programma da parte dell’OS.
8. Nella sequenza di Fibonacci calcolata ricorsivamente (fibonacci(n-1) + fibonacci(n-2)), perché le prestazioni sono pessime?
- A) Perché il tipo
intva continuamente in overflow. - B) Perché la RAM del sistema operativo si satura istantaneamente.
- C) Perché l’albero delle chiamate ricorsive ricalcola ripetutamente le stesse sotto-funzioni su rami separati, portando a una complessità temporale esponenziale .
- D) Perché
sscanfrallenta il processore.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: L’inefficienza è di natura algoritmica: la stessa sotto-chiamata (ad esempio fibonacci(5)) viene calcolata in modo ridondante migliaia di volte a causa dell’albero di sdoppiamento ricorsivo.
9. Cos’è la Tail Recursion (Ricorsione di Coda)?
- A) Una ricorsione eseguita solo alla fine del programma
main(). - B) Una tecnica per posizionare il cursore dei file alla fine dello stream.
- C) Una ricorsione in cui la chiamata ricorsiva rappresenta l’ultima istruzione in assoluto della funzione, permettendo l’ottimizzazione e il riciclo dello stack frame corrente.
- D) Una ricorsione applicabile solo su array di tipo
double.
▶ Mostra Risposta Corretta
Risposta corretta: C
Spiegazione: Essendo la chiamata ricorsiva l’ultimo passo, il compilatore sa che non vi sono operazioni residue da compiere dopo il ritorno. Di conseguenza, riutilizza lo stesso frame di attivazione senza sprecare ulteriore memoria sullo stack (Tail Call Optimization).
10. Quale complessità spaziale in termini di occupazione dello Stack possiede un algoritmo iterativo (for o while) rispetto a un algoritmo ricorsivo non ottimizzato?
- A) L’algoritmo iterativo occupa memoria dello Stack.
- B) L’algoritmo iterativo occupa memoria dello Stack, mentre quello ricorsivo non ottimizzato richiede frame di attivazione.
- C) Entrambi hanno complessità spaziale esponenziale .
- D) L’algoritmo iterativo non usa memoria RAM.
▶ Mostra Risposta Corretta
Risposta corretta: B
Spiegazione: I cicli iterativi mantengono le stesse variabili all’interno dello stesso frame di attivazione (spazio costante ). La ricorsione crea invece un frame per ciascun livello di ricorsione, portando a un’occupazione di memoria lineare rispetto alla profondità.
💻 Esercizi Pratici
Sezione intitolata “💻 Esercizi Pratici”Esercizio 1: Scrittura e Lettura Binaria di Array (bin_array_io.c)
Sezione intitolata “Esercizio 1: Scrittura e Lettura Binaria di Array (bin_array_io.c)”Si scriva un programma C che inizializzi un array di 10 numeri decimali double. Il programma deve salvare l’intero array in un file binario chiamato valori.bin con una singola chiamata a fwrite. Successivamente, riaprire lo stesso file in lettura binaria, caricare i dati in un secondo array usando fread e stamparli a schermo verificando la corretta corrispondenza dei dati.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
#define N 10
int main(void) {    double originali[N] = {1.1, 2.2, 3.3, 4.4, 5.5, 6.6, 7.7, 8.8, 9.9, 10.0};    double letti[N];
    // 1. Scrittura    FILE *out = fopen("valori.bin", "wb");    if (out == NULL) {        fprintf(stderr, "Errore in scrittura\n");        return 1;    }    fwrite(originali, sizeof(double), N, out);    fclose(out);
    // 2. Lettura    FILE *in = fopen("valori.bin", "rb");    if (in == NULL) {        fprintf(stderr, "Errore in lettura\n");        return 1;    }    size_t n_letti = fread(letti, sizeof(double), N, in);    fclose(in);
    if (n_letti != N) {        fprintf(stderr, "Errore di lettura: letti solo %zu elementi\n", n_letti);        return 1;    }
    printf("Dati letti con successo:\n");    for (int i = 0; i < N; i++) {        printf("  Elemento %d: %.1f\n", i, letti[i]);    }    return 0;}
Spiegazione dell’algoritmo:
Invece di iterare elemento per elemento, la funzione fwrite riceve come parametro l’indirizzo base dell’array originali ed esegue una copia esatta contigua di byte. Il medesimo blocco viene poi riletto linearmente tramite fread.
Esercizio 2: Calcolo della Dimensione di un File (file_size.c)
Sezione intitolata “Esercizio 2: Calcolo della Dimensione di un File (file_size.c)”Si scriva un programma C che accetti da riga di comando il nome di un file (di qualsiasi tipo, testo o binario). Utilizzando esclusivamente le funzioni fseek e ftell, il programma deve determinare la dimensione esatta del file in byte e visualizzarla a schermo.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
int main(int argc, char *argv[]) {    if (argc != 2) {        fprintf(stderr, "Uso: %s [nome_file]\n", argv[0]);        return 1;    }
    // Apriamo in binario per evitare conversioni di newline che alterano i conteggi byte    FILE *fp = fopen(argv[1], "rb");    if (fp == NULL) {        fprintf(stderr, "Errore: impossibile aprire il file '%s'\n", argv[1]);        return 1;    }
    // Saltiamo alla fine del file    fseek(fp, 0, SEEK_END);
    // ftell ci restituisce la posizione corrente, ovvero la dimensione del file    long dimensione = ftell(fp);    fclose(fp);
    printf("Il file '%s' ha una dimensione di %ld byte.\n", argv[1], dimensione);    return 0;}
Spiegazione dell’algoritmo:
Spostando il cursore interno alla fine assoluta del file tramite fseek(fp, 0, SEEK_END), interroghiamo lo stream tramite ftell(fp). Il valore intero restituito indica quanti byte precedono il cursore attuale, corrispondendo quindi alla grandezza fisica in byte del file.
Esercizio 3: Lettore di Record Binario Fissato (record_reader.c)
Sezione intitolata “Esercizio 3: Lettore di Record Binario Fissato (record_reader.c)”Si scriva un programma C che simuli un archivio di record di dimensioni fisse. Il record è composto esattamente da 50 byte contenenti una stringa (es. un cognome). Il programma deve:
- Scrivere un file
nomi.bincontenente 5 stringhe da 50 byte l’una. - Richiedere all’utente di inserire un indice numerico (da 0 a 4).
- Utilizzare
fseekper saltare direttamente a quell’indice senza scorrere i precedenti, leggere il cognome tramitefreade stamparlo.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>#include <string.h>
#define RECORD_SIZE 50#define N_RECORDS 5
int main(void) {    // 1. Creazione file con 5 record da 50 byte fissi ciascuno    FILE *out = fopen("nomi.bin", "wb");    if (out == NULL) return 1;
    char buffer[RECORD_SIZE];    const char *nomi[N_RECORDS] = {"Rossi", "Bianchi", "Verdi", "Russo", "Ferrari"};
    for (int i = 0; i < N_RECORDS; i++) {        memset(buffer, '\0', RECORD_SIZE); // Puliamo il buffer con byte nulli        strncpy(buffer, nomi[i], RECORD_SIZE - 1);        fwrite(buffer, RECORD_SIZE, 1, out);    }    fclose(out);
    // 2. Lettura mirata inserita da utente    int indice;    printf("Inserisci l'indice del record da leggere (0..%d): ", N_RECORDS - 1);    if (scanf("%d", &indice) != 1 || indice < 0 || indice >= N_RECORDS) {        fprintf(stderr, "Indice non valido.\n");        return 1;    }
    FILE *in = fopen("nomi.bin", "rb");    if (in == NULL) return 1;
    // Saltiamo direttamente al record desiderato    fseek(in, indice * RECORD_SIZE, SEEK_SET);
    char record_letto[RECORD_SIZE];    fread(record_letto, RECORD_SIZE, 1, in);    fclose(in);
    printf("Record %d letto: \"%s\"\n", indice, record_letto);    return 0;}
Spiegazione dell’algoritmo:
Garantendo record costanti di 50 byte tramite inizializzazione controllata con memset e strncpy, ogni record si trova esattamente all’offset i * RECORD_SIZE. La fseek posiziona la testina a quell’indirizzo e la fread carica esclusivamente i successivi 50 byte.
Esercizio 4: Massimo Elemento Ricorsivo (recursive_max.c)
Sezione intitolata “Esercizio 4: Massimo Elemento Ricorsivo (recursive_max.c)”Si scriva una funzione C ricorsiva int trova_max_ric(const int arr[], int size) che trovi e restituisca il valore massimo all’interno di un array di interi.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int trova_max_ric(const int arr[], int size) {    // Caso base: array con un solo elemento    if (size == 1) {        return arr[0];    }
    // Passo ricorsivo: trova il massimo della restante parte dell'array    int max_resto = trova_max_ric(arr + 1, size - 1);
    // Confronto tra l'elemento corrente e il massimo del resto    return (arr[0] > max_resto) ? arr[0] : max_resto;}
int main(void) {    int dati[] = {12, 45, 7, 89, 32, 54, 21};    int n = 7;    printf("Il massimo valore dell'array e': %d\n", trova_max_ric(dati, n));    return 0;}
Spiegazione dell’algoritmo:
Scomponiamo il problema: il massimo di un array è pari al massimo tra il primo elemento (arr[0]) e il massimo di tutto il resto dell’array (size - 1). La convergenza è garantita dallo scivolamento del puntatore arr + 1 e dal decremento di size fino al caso limite size == 1.
Esercizio 5: Palindromia Ricorsiva (recursive_palindrome.c)
Sezione intitolata “Esercizio 5: Palindromia Ricorsiva (recursive_palindrome.c)”Si scriva una funzione C ricorsiva int is_palindrome(const char *str, int start, int end) che restituisca 1 se la stringa compresa tra gli indici start ed end è palindroma, e 0 altrimenti.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <string.h>
int is_palindrome(const char *str, int start, int end) {    // Caso base: se gli indici si incrociano o sono uguali, la parola e' palindroma    if (start >= end) {        return 1;    }
    // Se i caratteri estremi sono diversi, non e' palindroma    if (str[start] != str[end]) {        return 0;    }
    // Passo ricorsivo: stringiamo l'intervallo escludendo gli estremi verificati    return is_palindrome(str, start + 1, end - 1);}
int main(void) {    const char *parola1 = "radar";    const char *parola2 = "catania";
    printf("\"%s\" e' palindroma? %s\n", parola1, is_palindrome(parola1, 0, strlen(parola1) - 1) ? "SI" : "NO");    printf("\"%s\" e' palindroma? %s\n", parola2, is_palindrome(parola2, 0, strlen(parola2) - 1) ? "SI" : "NO");
    return 0;}
Spiegazione dell’algoritmo:
Verifichiamo se il carattere d’inizio start coincide con quello finale end. In caso positivo, demandiamo la validazione alla stringa interna incrementando start e decrementando end. Se raggiungiamo un solo carattere o lo scontro degli indici senza discrepanze, la parola è palindroma.
Esercizio 6: Copia Inversa di File Binari (bin_reverse_copy.c)
Sezione intitolata “Esercizio 6: Copia Inversa di File Binari (bin_reverse_copy.c)”Si scriva un programma C che legga un file binario di interi (numeri.bin) e ne crei una copia chiamata numeri_inversi.bin contenente gli stessi valori ma disposti in ordine speculare (dall’ultimo al primo). Sfruttare opportunamente la funzione fseek con SEEK_END.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
int main(void) {    // Creiamo un file di test binario con i numeri da 1 a 5    FILE *out_test = fopen("numeri.bin", "wb");    if (out_test != NULL) {        int temp[] = {1, 2, 3, 4, 5};        fwrite(temp, sizeof(int), 5, out_test);        fclose(out_test);    }
    FILE *in = fopen("numeri.bin", "rb");    if (in == NULL) return 1;
    // Calcoliamo quanti interi sono presenti    fseek(in, 0, SEEK_END);    long size_in_bytes = ftell(in);    long n_elements = size_in_bytes / sizeof(int);
    FILE *out = fopen("numeri_inversi.bin", "wb");    if (out == NULL) {        fclose(in);        return 1;    }
    // Leggiamo ed invertiamo    for (long i = n_elements - 1; i >= 0; i--) {        fseek(in, i * sizeof(int), SEEK_SET);        int val;        fread(&val, sizeof(int), 1, in);        fwrite(&val, sizeof(int), 1, out);    }
    fclose(in);    fclose(out);    printf("Inversione binaria completata con successo.\n");    return 0;}
Spiegazione dell’algoritmo:
Dopo aver dedotto il numero totale di elementi leggendo la grandezza fisica del file, eseguiamo un ciclo iterativo decrescente. Ad ogni iterazione ci posizioniamo tramite fseek sul record ad offset i * sizeof(int), ne acquisiamo il singolo intero e lo accodiamo sequenzialmente nel file di output.
Esercizio 7: Fibonacci Tail-Recursive vs Esponenziale (fibonacci_compare.c)
Sezione intitolata “Esercizio 7: Fibonacci Tail-Recursive vs Esponenziale (fibonacci_compare.c)”Si scriva un programma C che implementi sia la versione classica a doppia ricorsione di Fibonacci sia la versione tail-recursive. Il programma deve richiedere all’utente un intero ed evidenziare visivamente la differenza di velocità di esecuzione stampando i risultati di entrambi i calcoli.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <time.h>
// Versione standard non ottimizzata: O(2^N)long long fib_standard(int n) {    if (n == 0) return 0;    if (n == 1) return 1;    return fib_standard(n - 1) + fib_standard(n - 2);}
// Versione tail-recursive ottimizzata: O(N) temporale, O(1) stacklong long fib_tail_helper(int n, long long a, long long b) {    if (n == 0) return a;    if (n == 1) return b;    return fib_tail_helper(n - 1, b, a + b);}
long long fib_tail(int n) {    return fib_tail_helper(n, 0, 1);}
int main(void) {    int n = 40; // Valore di test (soglia in cui lo standard incomincia ad essere molto lento)
    printf("Calcolo di Fibonacci(%d):\n", n);
    clock_t start = clock();    long long res_tail = fib_tail(n);    clock_t end = clock();    double time_tail = (double)(end - start) / CLOCKS_PER_SEC;    printf("[Tail Recursive] Risultato: %lld | Tempo: %f secondi\n", res_tail, time_tail);
    printf("Avvio calcolo standard non ottimizzato (attendere...):\n");    start = clock();    long long res_std = fib_standard(n);    end = clock();    double time_std = (double)(end - start) / CLOCKS_PER_SEC;    printf("[Standard]       Risultato: %lld | Tempo: %f secondi\n", res_std, time_std);
    return 0;}
Spiegazione dell’algoritmo:
La ricorsione classica esplode con una complessità temporale di a causa del ricalcolo ridondante delle foglie dell’albero delle chiamate. La versione tail-recursive linearizza l’algoritmo () passando i risultati parziali intermedi come argomenti accumulo (a e b) senza mantenere chiamate in sospeso nello Stack.
Esercizio 8: Ricerca Binaria Ricorsiva (recursive_binary_search.c)
Sezione intitolata “Esercizio 8: Ricerca Binaria Ricorsiva (recursive_binary_search.c)”Si scriva un programma C contenente una funzione ricorsiva per effettuare la ricerca binaria su un array ordinato di interi: int binary_search_ric(const int arr[], int low, int high, int target).
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int binary_search_ric(const int arr[], int low, int high, int target) {    // Caso base: elemento non trovato    if (low > high) {        return -1;    }
    int mid = low + (high - low) / 2;
    // Caso base: elemento trovato al centro    if (arr[mid] == target) {        return mid;    }
    // Passo ricorsivo: decidiamo quale meta' esplorare    if (arr[mid] > target) {        return binary_search_ric(arr, low, mid - 1, target);    } else {        return binary_search_ric(arr, mid + 1, high, target);    }}
int main(void) {    int elenco[] = {2, 4, 8, 12, 16, 23, 38, 56, 72, 91};    int n = 10;    int target = 23;
    int pos = binary_search_ric(elenco, 0, n - 1, target);    if (pos != -1) {        printf("Elemento %d trovato alla posizione %d\n", target, pos);    } else {        printf("Elemento %d non presente\n", target);    }    return 0;}
Spiegazione dell’algoritmo:
Scomponiamo l’array calcolando l’indice mediano mid. Se il valore coincide, lo restituiamo. Altrimenti verifichiamo se il target sia inferiore o superiore ad arr[mid], lanciando la medesima funzione ricorsiva solo sulla sotto-porzione ordinata d’interesse.
Esercizio 9: Hexadecimal File Dumper (hex_dumper.c)
Sezione intitolata “Esercizio 9: Hexadecimal File Dumper (hex_dumper.c)”Si realizzi una semplice utility C che prenda da riga di comando il nome di un file e lo stampi a schermo byte per byte in formato esadecimale (esattamente come un hexdump elementare), stampando 16 byte esadecimali per ciascuna riga.
💻 Mostra Soluzione e Codice C
#include <stdio.h>#include <stdlib.h>
int main(int argc, char *argv[]) {    if (argc != 2) {        fprintf(stderr, "Uso: %s [nome_file]\n", argv[0]);        return 1;    }
    FILE *fp = fopen(argv[1], "rb");    if (fp == NULL) {        fprintf(stderr, "Errore nell'aprire il file '%s'\n", argv[1]);        return 1;    }
    int byte;    int contatore = 0;
    printf("Offset    00 01 02 03 04 05 06 07 08 09 0A 0B 0C 0D 0E 0F\n");    printf("----------------------------------------------------------\n");
    while ((byte = fgetc(fp)) != EOF) {        if (contatore % 16 == 0) {            printf("%08X  ", contatore);        }
        printf("%02X ", byte);        contatore++;
        if (contatore % 16 == 0) {            printf("\n");        }    }
    if (contatore % 16 != 0) {        printf("\n");    }
    fclose(fp);    return 0;}
Spiegazione dell’algoritmo:
Leggiamo singolarmente i byte dallo stream aperto in modalità binaria grezza con fgetc. Tramite l’operatore modulo % 16 determiniamo la fine della riga visualizzata stampando l’offset in byte esadecimale all’inizio ed un ritorno a capo ogni 16 caratteri estratti.
Esercizio 10: Moltiplicazione Russa Ricorsiva (russian_multiplication.c)
Sezione intitolata “Esercizio 10: Moltiplicazione Russa Ricorsiva (russian_multiplication.c)”L’algoritmo di moltiplicazione russa (o moltiplicazione contadina) calcola il prodotto di due interi positivi e dimezzando ripetutamente (divisione intera) e raddoppiando ad ogni iterazione, finché diventa pari a . Il risultato finale è la somma di tutti i valori di in corrispondenza delle righe in cui è dispari.
Si scriva una funzione C ricorsiva int prod_russo(int a, int b) che implementi questo algoritmo.
💻 Mostra Soluzione e Codice C
#include <stdio.h>
int prod_russo(int a, int b) {    // Caso base    if (a == 1) {        return b;    }
    // Se a e' dispari, accumuliamo b piu' il risultato della chiamata ricorsiva    if (a % 2 != 0) {        return b + prod_russo(a / 2, b * 2);    } else {        // Se a e' pari, passiamo alla chiamata ricorsiva dimezzando a e raddoppiando b        return prod_russo(a / 2, b * 2);    }}
int main(void) {    int x = 27;    int y = 35;    printf("Prodotto russo di %d * %d = %d (Verifica matematica: %d)\n", x, y, prod_russo(x, y), x * y);    return 0;}
Spiegazione dell’algoritmo:
Sfruttiamo l’induzione matematica: se a è dispari, il prodotto è pari a b + prod_russo(a/2, b*2). Se a è pari, equivale semplicemente a prod_russo(a/2, b*2). Il caso limite di terminazione è a == 1 che restituisce il valore cumulato di b.